Kopieren statt Erfinden, Teil 1:
Wie man ein KI-Modell kopiert
Am 22. Juli veröffentlichte Michael Kratsios einen kurzen Beitrag auf X. Er leitet das Wissenschaftsbüro im Weißen Haus. Darin behauptete er, das chinesische Unternehmen Moonshot habe Anthropics Modell Fable abgeschöpft, um daraus sein eigenes Modell Kimi K3 zu bauen. Einen Tag zuvor hatte Finanzminister Scott Bessent bereits Sanktionen ins Gespräch gebracht. Technische Belege wurden bis Ende Juli nicht vorgelegt.
Der Fachbegriff für das, was da vorgeworfen wird, lautet Distillation. Der Name ist aus der Chemie geborgt und meint dasselbe wie beim Schnapsbrennen. Man zieht aus etwas Großem den Kern heraus und füllt ihn in ein kleineres Gefäß.
Das Verfahren ist weder neu noch heimlich. Es steht seit 2015 in einem öffentlichen Paper und wird von allen großen Anbietern eingesetzt. Google beschreibt in der Dokumentation seiner Gemma-Modelle ausdrücklich, dass die kleineren Varianten genau so entstanden sind.
Wie wenig die Methode als solche umstritten ist, zeigte sich zwei Tage nach dem Vorwurf. Am 24. Juli unterzeichnete OpenAI einen offenen Brief, der Distillation als weit verbreitete Technik zur Modellverbesserung verteidigt und vor pauschalen Beschränkungen warnt.
Was den Fall politisch brisant macht, ist also nicht die Technik. Es ist die Frage, an wessen Modell man sie anwendet.
Bevor man über einen solchen Vorwurf urteilen kann, muss man wissen, was dabei überhaupt geschieht. Dieser erste Teil erklärt das Verfahren. Was beim Destillieren übertragen wird, was der Zugang zum fremden Modell hergeben muss, wie der Ablauf in der Praxis aussieht und wo er an eine Grenze stößt. Die Kosten und die politische Auseinandersetzung folgen in den Teilen zwei und drei.
Der Kern: Der Schüler lernt aus den falschen Antworten
Die Grundidee stammt von Geoffrey Hinton, Oriol Vinyals und Jeff Dean, veröffentlicht 2015. Das Problem, das sie lösen wollten, war praktisch. Große Modelle sind genau, aber teuer im laufenden Betrieb. Kleine Modelle sind billig, aber schwächer. Lässt sich die Stärke des großen Modells in ein kleines übertragen?
Der Trick liegt darin, was man dem kleinen Modell zeigt.
Trainiert man ein Modell klassisch, bekommt es die richtige Antwort vorgesetzt. Auf dem Bild ist ein BMW zu sehen, also lautet die Zielvorgabe: BMW zu hundert Prozent, alles andere null. Fachleute nennen das ein Hard Label. Es ist eindeutig und wenig informativ.
Ein bereits trainiertes Modell antwortet anders. Es sagt nicht nur BMW, es liefert eine ganze Wahrscheinlichkeitsverteilung. BMW mit hoher Wahrscheinlichkeit, Müllwagen mit einer kleinen, Karotte mit einer verschwindend kleinen. Und genau darin steckt etwas, das in der richtigen Antwort fehlt: Das große Modell verrät, dass ein BMW eher mit einem Müllwagen verwechselt werden könnte als mit einer Karotte. Es verrät, wie es die Welt sortiert.
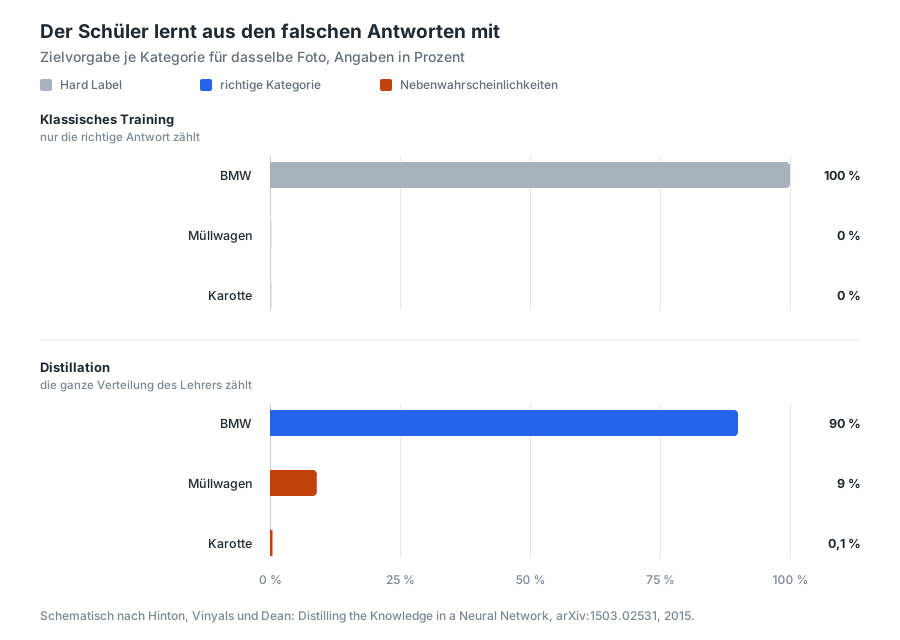
Diese Nebenwahrscheinlichkeiten sind allerdings winzig und fallen beim Training kaum ins Gewicht. Deshalb drehen die Autoren an einem Regler, den sie Temperatur nennen. Eine höhere Temperatur macht die Verteilung flacher, sodass auch die kleinen Werte wirksam werden. Nach dem Training wird der Regler wieder zurückgestellt.
Wie stark der Effekt ist, zeigt ein Experiment aus demselben Paper, durchgeführt an handgeschriebenen Ziffern. Die Autoren entfernten die Ziffer 3 vollständig aus dem Datensatz, auf dem der Schüler trainiert wurde. Das kleine Modell bekam also nie eine 3 zu sehen. Trotzdem erkannte es anschließend rund 87 Prozent aller Dreien korrekt, allein aus dem, was die Verteilungen zu den anderen Ziffern über die 3 verrieten. Nachdem die Autoren einen einzelnen Schwellwert für diese Klasse nachjustiert hatten, waren es 98,6 Prozent. Diese Nachjustierung wurde auf den Testdaten optimiert und gehört zur Ehrlichkeit dazu. Bemerkenswert bleibt die erste Zahl.
Der Schüler lernt also nicht nur Antworten. Er lernt die Ordnung dahinter.
Der Zugang entscheidet, was überhaupt geht
Damit ist auch klar, dass es einen Unterschied macht, wessen Modell man destilliert.
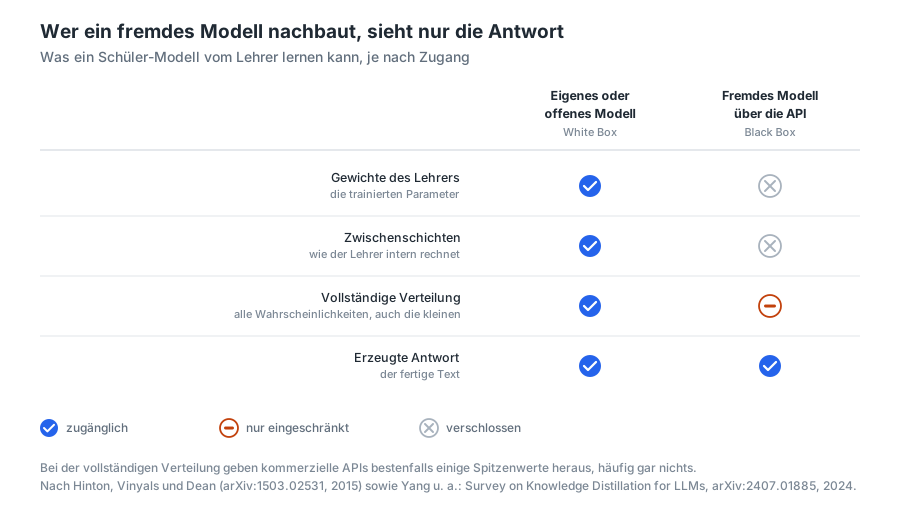
Wer ein eigenes oder ein offenes Modell als Lehrer nutzt, kommt an alles heran: an die trainierten Parameter, an die Zwischenschichten, an die vollständige Wahrscheinlichkeitsverteilung. Das ist der Normalfall in den Laboren und heißt White-Box-Distillation.
Wer ein fremdes, geschlossenes Modell abschöpfen will, hat davon wenig. Er hat eine API, er stellt Fragen, er bekommt Texte zurück. Manche Anbieter liefern immerhin die Wahrscheinlichkeiten der wenigen wahrscheinlichsten Token mit, andere gar nichts. Das ist Black-Box-Distillation. Sie ist technisch etwas anderes als das, was Hinton beschrieben hat. Wo die Verteilung fehlt oder nur ausschnittsweise vorliegt, bleibt im Kern ein Supervised Fine-Tuning auf fremden Antworten.
Was sich über eine reine API tatsächlich herausholen lässt, ist erstaunlich präzise und zugleich erstaunlich begrenzt. Ein Team um Nicholas Carlini zeigte 2024 auf der Konferenz ICML, dass sich für weniger als 20 Dollar die vollständige Ausgabe-Projektionsschicht älterer OpenAI-Modelle rekonstruieren lässt, exakt bis auf mathematische Symmetrien. Bei GPT-3.5-Turbo ermittelten sie immerhin die Größe dieser Schicht. Die vollständige Matrix hätte nach ihrer Schätzung unter 2.000 Dollar gekostet. Möglich war das, weil die APIs Wahrscheinlichkeiten für die wahrscheinlichsten Token mitlieferten. Nach der Meldung an die Anbieter haben OpenAI und Google genau das eingeschränkt.
Das klingt dramatisch, bleibt aber eine einzelne Schicht am Rand des Modells. Kein Modell, keine Fähigkeiten, nicht die Gewichte, auf die es ankommt.
Näher an einem echten Nachbau liegt ein Paper von Lewis Birch und Kollegen aus dem Jahr 2023. Für 50 Dollar an API-Kosten destillierten sie aufgabenspezifisches Wissen aus ChatGPT-3.5 in ein deutlich kleineres Modell und erreichten 73 Prozent exakte Übereinstimmung bei den Antworten. Auch das ist kein Klon, sondern ein Ausschnitt für eine eng umrissene Aufgabe.
Wie das in der Praxis abläuft
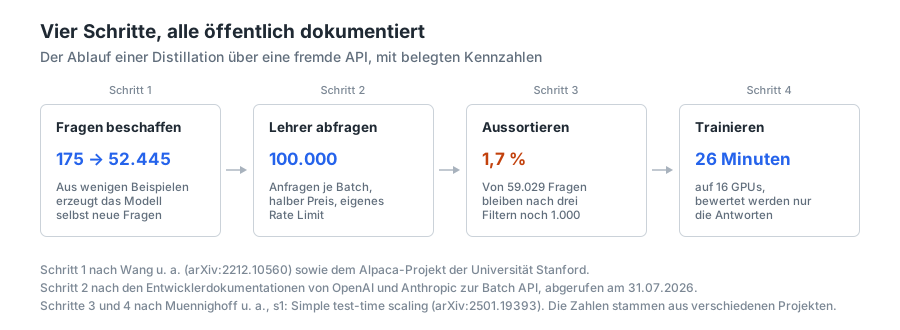
Bis hierhin klang das nach Theorie. Tatsächlich ist der Ablauf gut dokumentiert, weil mehrere Forschungsgruppen ihn offen beschrieben und ihre Werkzeuge veröffentlicht haben. Er besteht aus vier Schritten.
Der erste Schritt ist das Beschaffen der Fragen. Antworten braucht man nicht, die liefert später der Lehrer. Man braucht Fragen. Und die sind erstaunlich billig zu bekommen.
Das bekannteste Verfahren heißt Self-Instruct und stammt von einer Gruppe um Yizhong Wang aus dem Jahr 2022. Die Autoren schrieben 175 Aufgaben von Hand. Dann legten sie dem Modell jeweils acht davon vor und ließen es neue schreiben. Damit die Sammlung nicht in Wiederholungen erstickt, wurde eine neu erzeugte Aufgabe nur aufgenommen, wenn sie sich von allen vorhandenen deutlich genug unterschied. Am Ende standen 52.445 Aufgaben. Aus 175 handgeschriebenen Beispielen wurden gut fünfzigtausend, ein Verhältnis von etwa eins zu dreihundert. Kosten für die Erzeugung: rund 600 Dollar.
Stanfords Alpaca-Projekt übernahm genau dieses Seed-Set ein Jahr später und erzeugte damit seine 52.000 Beispiele. Ein Detail aus dem zugehörigen Code zeigt, wie sehr es hier ums Rechnen geht: Statt eine Aufgabe pro Anfrage zu erzeugen, ließen sich die Autoren zwanzig auf einmal ausgeben. Das drückt die Kosten um etwa eine Größenordnung.
Der zweite Beschaffungsweg führt über echte Nutzerfragen. Davon gibt es öffentliche Sammlungen. Der Datensatz WildChat etwa entstand, indem Forschende kostenlosen Zugang zu ChatGPT anboten und im Gegenzug die Gesprächsverläufe einsammelten, mit Einwilligung der Nutzer. Eine Million Konversationen. Die Fragen sind damit gratis, die Antworten holt man sich später beim Modell der Wahl.
Der zweite Schritt ist das Abfragen selbst. Hier liegt die eigentliche Überraschung. Man könnte annehmen, dass die Anbieter Massenabfragen erschweren. Das Gegenteil trifft zu. Sie stellen den passenden Kanal selbst bereit.
Beide großen Anbieter betreiben eine Batch API: Man reicht eine große Datei mit Fragen ein und holt die Antworten innerhalb von 24 Stunden ab. Der Preis dafür liegt bei der Hälfte. Bei OpenAI passen bis zu 50.000 Anfragen in einen Batch, bei Anthropic bis zu 100.000. Und in der OpenAI-Dokumentation steht ausdrücklich, dass dieser Kanal nicht auf die normalen Rate Limits angerechnet wird.
Wirtschaftlich ist das völlig vernünftig, weil es die Auslastung der Rechenzentren glättet. Für das Abschöpfen bedeutet es allerdings: Das Rate Limit, das man als natürliche Bremse vermuten würde, ist keines. Der Weg zu hunderttausend Antworten am Stück ist ein dokumentiertes Produktmerkmal.
Der dritte Schritt ist das Aussortieren. Er fehlt in populären Darstellungen fast immer und entscheidet trotzdem über die Qualität.
Wie radikal dabei gesiebt wird, zeigt das Paper s1 von einer Gruppe um Niklas Muennighoff aus dem Jahr 2025. Die Autoren sammelten 59.029 Fragen aus sechzehn Quellen. Ein erster Durchgang entfernte alles mit Formatproblemen oder fehlgeschlagenen Abrufen, es blieben 51.581. Ein zweiter warf alle zu leichten Fragen weg, die ein Modell ohnehin schon beantworten konnte. Übrig blieben 24.496. Ein dritter sorgte dafür, dass die Fachgebiete gleichmäßig verteilt sind. Übrig blieben tausend Beispiele.
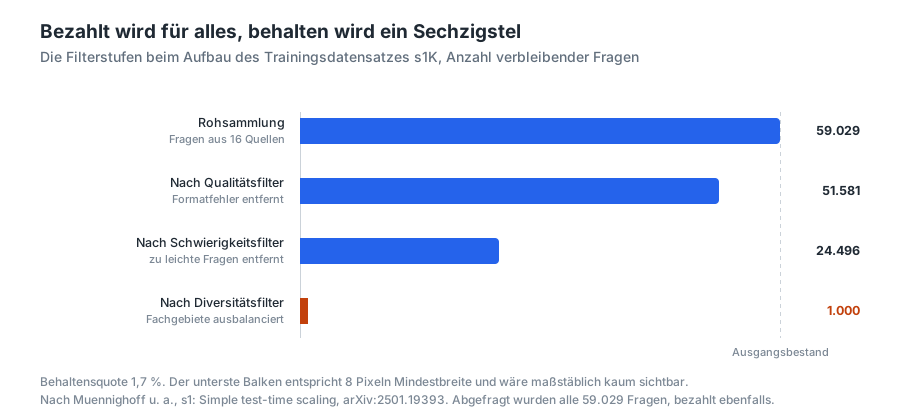
Das sind 1,7 Prozent. Bezahlt wurde für alles, behalten wurde ein Sechzigstel.
Wie gut man aussortiert, ist dabei selbst ein Kostenfaktor. Das Team von Bespoke Labs ersetzte in einem Nachbau eines fremden Filters die regelbasierte Prüfung durch ein kleines Sprachmodell als Prüfer. Der Anteil der korrekt erkannten richtigen Lösungen stieg damit von 25 auf 73 Prozent. Aus denselben Rohdaten wurde fast dreimal so viel brauchbares Material.
Eine Warnung gehört dazu, weil sie der naheliegenden Lehre widerspricht. Das Projekt OpenThoughts hat über tausend kontrollierte Versuche zum Aufbau solcher Datensätze durchgeführt. Ergebnis: Beim Filtern der Antworten schlug keine Strategie die Vergleichsvariante, die einfach alles behielt. Beim Filtern der Fragen dagegen brachte die beste Strategie vier bis sechs Prozent. Was zählt, ist also die Auswahl der Fragen, nicht die Nachbearbeitung der Antworten. Dasselbe Paper fand außerdem, dass ein kleineres Modell als Lehrer bessere Ergebnisse lieferte als das stärkere. Der stärkste Lehrer ist nicht automatisch der beste.
Der vierte Schritt ist das Training. Technisch ist er der unspektakulärste.
Frage und Antwort stehen zusammen in einer einzigen Zeichenkette. Beim Training wird aber nur der Antwortteil bewertet. Das Modell lernt, was es auf eine Frage antworten soll, nicht, wie man Fragen stellt. In den gängigen Bibliotheken ist das eine Voreinstellung, kein Kunstgriff.
Die Zahlen dazu sind die eigentliche Pointe des Abschnitts. Das erwähnte s1-Modell wurde in 26 Minuten auf sechzehn GPUs fertig trainiert. Alpaca brauchte drei Stunden auf acht GPUs und kostete dabei nach Angabe der Autoren unter 100 Dollar. Das Berkeley-Projekt Sky-T1 lag bei 19 Stunden und rund 450 Dollar. Und das Rezept dahinter ist über drei Jahre und mehrere Größenordnungen hinweg praktisch unverändert geblieben: drei Epochen, eine kleine Lernrate, Batch-Größen um hundert.
Auch die Hardware-Hürde ist niedriger, als man vermutet. Wer ein Modell mit sieben Milliarden Parametern nicht vollständig, sondern nur an eingefügten kleinen Zusatzschichten per Fine-Tuning anpasst (LoRA, in der sparsamen Variante QLoRA), kommt mit sechs Gigabyte VRAM aus. Das ist eine bessere Gaming-Grafikkarte.
Bleibt der Unterschied zwischen den beiden Zugangswegen aus dem vorigen Abschnitt. Er ist in der Praxis ernüchternd klein. In der verbreiteten Bibliothek TRL liegen beide Verfahren in derselben Klasse nebeneinander und unterscheiden sich in zwei Parametern. Der eine schaltet zwischen Lernen an fremden Texten und Lernen an den eigenen Fehlversuchen um, der andere legt fest, wie die Abweichung zwischen Lehrer und Schüler gemessen wird. Ob man also über eine API abschöpft oder mit heruntergeladenen Gewichten arbeitet, ist im Code eine Konfigurationszeile. Der Unterschied liegt nicht im Verfahren, sondern im Zugang.
Zuletzt die Frage, ob das Spuren hinterlässt. Sie ist für die Vorwürfe aus der Politik entscheidend, denn ohne Nachweis bleibt jeder Verdacht ein Verdacht.
Es gibt einen technisch eleganten Ansatz. Versieht ein Anbieter seine Ausgaben mit einem statistischen Wasserzeichen, bleibt davon im Schülermodell ein messbarer Rest zurück. Ein Paper von 2024 nennt das treffend radioaktiv und zeigt, dass der Nachweis selbst dann noch gelingt, wenn nur fünf Prozent des Trainingstexts markiert waren. Nur hat ein Folge-Paper von 2025 gezeigt, dass sich diese Markierung vollständig entfernen lässt, indem man die Antworten vor dem Training umformulieren lässt. Das Wasserzeichen fängt Nachlässige, nicht Entschlossene.
Bleibt der schlichteste Hinweis. Modelle, die auf fremden Ausgaben trainiert wurden, behaupten gelegentlich in Selbstauskünften, sie seien ein anderes Modell. Ein Paper von 2025 hat daraus ein messbares Verfahren gemacht und kommt zu dem Schluss, dass die meisten bekannten Modelle einen hohen Distillationsgrad aufweisen, mit wenigen Ausnahmen. Das ist ein Indiz, kein Beweis.
Und darin steckt das Grundproblem der Anbieter. Wer ein Reasoning-Modell verkauft, muss seine Reasoning-Schritte ausliefern, damit das Produkt etwas taugt. Genau diese Schritte sind aber das Trainingsmaterial des Nachahmers. Jede Gegenmaßnahme verschlechtert entweder das Produkt oder lässt sich umgehen.
Die Grenzen: Was der Schüler nicht erbt
Wie weit ein Nachbau kommt, lässt sich an DeepSeek selbst ablesen. Die Firma hat ihr eigenes Modell destilliert und den Vorgang dokumentiert.
Am Anfang stand der teure Teil. DeepSeek trainierte sein bestehendes Basismodell V3 über Reinforcement Learning zum Reasoning-Modell R1 weiter. Die begutachtete Fassung des Papers beziffert diesen Schritt erstmals mit 147.000 GPU-Stunden auf H800-Karten, nach eigener Rechnung rund 294.000 Dollar. Das ist die Arbeit, bei der vorher niemand weiß, ob sie aufgeht.
Auf dem Weg dorthin fiel etwas ab. Für eine Zwischenstufe des eigenen Trainings brauchte das Team einen Satz sauberer Beispiele. Es ließ das Modell antworten, prüfte die Ergebnisse und behielt nur die richtigen. So entstanden 600.000 Reasoning-Spuren, ergänzt um 200.000 Beispiele anderer Art. Die Erzeugung kostete 5.000 Rechenstunden und damit rund 10.000 Dollar. Gemessen am gesamten Post-Training von R1 sind das gut drei Prozent.
Diese Beispiele wurden anschließend ein zweites Mal verwendet. DeepSeek nahm sechs fremde, frei verfügbare Modelle von Qwen und Llama und unterzog sie darauf einem Fine-Tuning. Kein Reinforcement Learning, keine Sonderverfahren, zwei bis drei Epochen. Der gesamte Aufwand steckte in Material, das ohnehin schon vorlag.
Übertragen wird dabei kein Wissen, sondern ein Verhalten. Die Reasoning-Spuren zeigen ein Modell, das seine Zwischenschritte prüft, Fehler bemerkt und zurückgeht. Ein starkes Basismodell beherrscht diese Schritte im Prinzip, wendet sie aber von sich aus nicht an. Das Fine-Tuning bringt ihm bei, es zu tun.
Dass der Weg über erzeugte Texte lief, hat einen technischen Grund. Das Lehrbuchverfahren überträgt keine Texte, sondern Wahrscheinlichkeiten. Der Schüler bekommt für jede Stelle die vollständige Einschätzung des Lehrers, also auch, welche falschen Antworten dieser für wie plausibel hielt. Zwischen R1 und den Modellen von Qwen und Llama ging das nicht ohne Weiteres. Sie zerlegen Text in unterschiedliche Token und arbeiten mit verschiedenen Vokabularen. Ohne gemeinsamen Ausgaberaum gibt es nichts abzugleichen. Es existieren Verfahren, die zwischen solchen Vokabularen vermitteln, aber sie kosten zusätzliche Arbeit. DeepSeek ging über Texte.
Das Ergebnis ist beachtlich. Das destillierte 32-Milliarden-Modell schlägt QwQ-32B-Preview, den bis dahin stärksten offenen Reasoning-Ansatz dieser Größe, in allen sechs berichteten Benchmarks. Auf dem Mathematikwettbewerb AIME steht es bei 72,6 gegen 50,0 Punkte.
Was diese Abkürzung wert ist, zeigt ein Kontrollversuch im selben Paper. Das Team nahm dasselbe Basismodell und trainierte es stattdessen über mehr als zehntausend Schritte Reinforcement Learning, also auf dem harten Weg. Heraus kamen 47,0 Punkte. Der Umweg über den fertigen Lehrer war nicht nur billiger, sondern deutlich besser.
Und dort beginnt die Grenze. Keines der sechs destillierten Modelle kommt an R1 heran. Auf AIME steht der Lehrer bei 79,8 und die besten Schüler bei 72,6 und 70,0. Auf der Programmierplattform Codeforces liegt R1 bei 2029 Punkten, die Schüler bei 1691 und 1633. In jedem gemeinsam berichteten Benchmark gewinnt der Lehrer, meist deutlich. Das Paper zieht diesen Vergleich an keiner Stelle selbst. Die Schüler treten ausschließlich gegen fremde Modelle an. Wer den Abstand zum eigenen Lehrer wissen will, muss die Zahlen aus zwei Tabellen zusammensuchen.
Kann ein Schüler seinen Lehrer also überhaupt überholen? Er kann es. Bei der Qwen3-Familie übertreffen mehrere destillierte Modelle ihre eigenen Lehrer messbar.
Dort lief die Übertragung allerdings anders als bei DeepSeek. Lehrer und Schüler stammen aus derselben Familie und teilen ihr Vokabular, also konnte das Team die Wahrscheinlichkeitsverteilungen direkt abgleichen, genau nach dem Lehrbuch. Umso aufschlussreicher ist, wo die Siege liegen. Beim Befolgen von Anweisungen, beim Einhalten vorgegebener Formate, bei strukturierten Logikrätseln. In den Benchmarks für Mathematik, Programmierung und Fachwissen verliert auch dort jeder Schüler gegen seinen Lehrer. Der Bericht nennt zwei Lehrermodelle, ohne anzugeben, welcher Schüler von welchem lernte. Gemessen am stärkeren der beiden reichen die Vorsprünge von zwei Zehnteln bis gut neun Punkten, die Rückstände von gut fünf bis knapp elf.
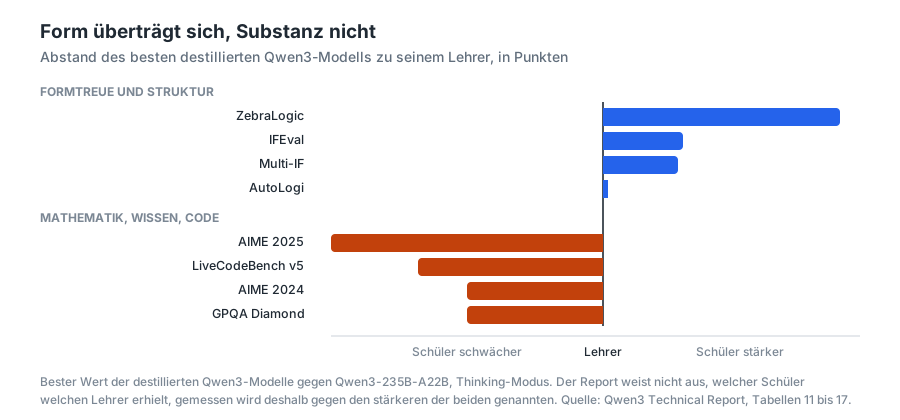
Dieselbe Trennlinie zeigt sich also bei zwei verschiedenen Verfahren, einmal über Texte und einmal über Verteilungen. Sie hängt nicht an der Methode. Gut überträgt sich die Form. Schlecht überträgt sich die Substanz.
Genau das hatte ein Paper von Arnav Gudibande und Kollegen bereits 2023 gezeigt, als sie offene Modelle auf ChatGPT-Ausgaben trainierten. Menschliche Bewerter hielten die Ergebnisse zunächst für konkurrenzfähig. In gezielten Benchmarks fiel das Bild auseinander. Stil und Ton waren hervorragend übernommen, die faktische Zuverlässigkeit kaum. Ihr Fazit lautete, Nachahmung sei ein falsches Versprechen. Drei Modellgenerationen später steht derselbe Befund, nur mit besseren Zahlen.
Die ganze Rechnung geht ohnehin nur auf, weil zwei Dinge bereits existierten. V3 als Basismodell und R1 als fertiger Lehrer. Ein Team von Apple hat 2025 den anderen Fall durchgerechnet. Wer den Lehrer erst selbst bauen muss und am Ende nur ein einziges kleines Modell braucht, fährt mit gewöhnlichem Training besser. Distillation lohnt sich, wenn der Lehrer ohnehin dasteht oder wenn viele Schüler aus ihm entstehen. Beides traf bei DeepSeek zu. Für einen Nachahmer, der ein fremdes Modell abschöpft, trifft es noch deutlicher zu, denn er trägt die Kosten des Lehrers überhaupt nicht.
Was bleibt
Distillation ist ein Übertragungsverfahren, kein Erzeugungsverfahren. Sie holt aus einem fertigen Modell heraus, was dieses Modell tut. Dann legt sie es in ein kleineres. Das funktioniert erstaunlich gut, erstaunlich schnell und mit erstaunlich wenig Material. Tausend sorgfältig ausgewählte Beispiele und sechsundzwanzig Minuten Rechenzeit genügen, um ein Modell auf ein Niveau zu heben, für das ein anderes Team Monate gebraucht hat.
Was dabei übergeht, ist die Form des Denkens. Was zurückbleibt, ist die Verlässlichkeit dahinter. Wer destilliert, arbeitet an einem Ziel, das ein anderer gesteckt hat. Er kommt schnell heran und er kommt billig heran. In der Form kann er den Lehrer sogar überholen. In der Sache nicht.
Für Unternehmen folgt daraus ein sehr praktischer Hinweis. Wenn ein Nachbau Stil und Ton übernimmt, die Zuverlässigkeit aber nicht, dann messen Leaderboards und Blindvergleiche bevorzugt genau das, was sich gut übertragen lässt. Wer ein Modell danach auswählt, prüft die falsche Eigenschaft. Verlässlicher ist ein Test an den eigenen Aufgaben.
Im zweiten Teil geht es darum, was dieses Abschöpfen tatsächlich kostet und was das Original gekostet hat. Der dritte Teil behandelt den politischen Streit und die Frage, warum Europa den billigen Weg nicht geht.
Quellen
- Geoffrey Hinton, Oriol Vinyals, Jeff Dean: Distilling the Knowledge in a Neural Network. Workshop-Beitrag, arXiv:1503.02531, 2015. https://arxiv.org/abs/1503.02531
- Chuanpeng Yang u. a.: Survey on Knowledge Distillation for Large Language Models. Preprint, arXiv:2407.01885, 2024. https://arxiv.org/abs/2407.01885
- Nicholas Carlini u. a.: Stealing Part of a Production Language Model. ICML 2024, arXiv:2403.06634. https://arxiv.org/abs/2403.06634
- Lewis Birch u. a.: Model Leeching. An Extraction Attack Targeting LLMs. arXiv:2309.10544, 2023. https://arxiv.org/abs/2309.10544
- Arnav Gudibande u. a.: The False Promise of Imitating Proprietary LLMs. Preprint, arXiv:2305.15717, 2023. https://arxiv.org/abs/2305.15717
- DeepSeek-AI: DeepSeek-R1. Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. In: Nature, Band 645, 2025, S. 633–638. Trainingskosten, Distillationsabschnitt und der Vergleich gegen Reinforcement Learning stehen in der Supplementary Information. https://doi.org/10.1038/s41586-025-09422-z
- Victor Sanh u. a.: DistilBERT, a distilled version of BERT. Preprint, arXiv:1910.01108, 2019. https://arxiv.org/abs/1910.01108
- Saurav Muralidharan u. a.: Compact Language Models via Pruning and Knowledge Distillation. Preprint, arXiv:2407.14679, 2024. https://arxiv.org/abs/2407.14679
- Dan Busbridge u. a.: Distillation Scaling Laws. ICML 2025, arXiv:2502.08606. https://arxiv.org/abs/2502.08606
- Yizhong Wang u. a.: Self-Instruct. Aligning Language Models with Self-Generated Instructions. ACL 2023, arXiv:2212.10560. https://arxiv.org/abs/2212.10560
- Wenting Zhao u. a.: WildChat. 1M ChatGPT Interaction Logs in the Wild. ICLR 2024, arXiv:2405.01470. https://arxiv.org/abs/2405.01470
- Niklas Muennighoff u. a.: s1. Simple test-time scaling. EMNLP 2025, arXiv:2501.19393. https://arxiv.org/abs/2501.19393
- Etash Guha u. a.: OpenThoughts. Data Recipes for Reasoning Models. Preprint, arXiv:2506.04178, 2025. https://arxiv.org/abs/2506.04178
- Bespoke Labs: Bespoke-Stratos. The unreasonable effectiveness of reasoning distillation. 2025. Angabe des Teams zur Ausbeute des Prüfschritts. https://www.bespokelabs.ai/blog/bespoke-stratos-the-unreasonable-effectiveness-of-reasoning-distillation
- OpenAI: Batch API. Entwicklerdokumentation, abgerufen am 31.07.2026. https://developers.openai.com/api/docs/guides/batch
- Anthropic: Message Batches API. Entwicklerdokumentation, abgerufen am 31.07.2026. https://platform.claude.com/docs/en/build-with-claude/batch-processing
- Edward Hu u. a.: LoRA. Low-Rank Adaptation of Large Language Models. ICLR 2022, arXiv:2106.09685, sowie Tim Dettmers u. a.: QLoRA. NeurIPS 2023, arXiv:2305.14314. Speicherangaben nach der Hardwaretabelle von LLaMA-Factory. https://github.com/hiyouga/LLaMA-Factory
- Rishabh Agarwal u. a.: On-Policy Distillation of Language Models. ICLR 2024, arXiv:2306.13649. Die Parameter stammen aus der Dokumentation der Bibliothek TRL. https://huggingface.co/docs/trl/en/gkd_trainer
- Tom Sander u. a.: Watermarking Makes Language Models Radioactive. NeurIPS 2024, arXiv:2402.14904. https://arxiv.org/abs/2402.14904
- Leyi Pan u. a.: Can LLM Watermarks Robustly Prevent Unauthorized Knowledge Distillation? ACL 2025, arXiv:2502.11598. https://arxiv.org/abs/2502.11598
- Sunbowen Lee u. a.: Quantification of Large Language Model Distillation. ACL 2025, arXiv:2501.12619. https://arxiv.org/abs/2501.12619
- Qwen Team: Qwen3 Technical Report. Preprint, arXiv:2505.09388, 2025. Die Werte der destillierten Modelle und ihrer Lehrer stehen in den Tabellen 11 bis 17. https://arxiv.org/abs/2505.09388
- Rohan Taori u. a.: Alpaca. A Strong, Replicable Instruction-Following Model. Stanford CRFM, 2023. Kostenangabe des Teams. https://crfm.stanford.edu/2023/03/13/alpaca.html
- Gemma Team, Google DeepMind: Gemma 2. Improving Open Language Models at a Practical Size. Technischer Bericht, arXiv:2408.00118. https://arxiv.org/abs/2408.00118
- Michael Kratsios: Beitrag auf X vom 22.07.2026 (@mkratsios47). Wortlaut des Vorwurfs gegen Moonshot. https://x.com/mkratsios47/status/2079933645888880708
- TechCrunch: Treasury threatens sanctions after White House claims Moonshot distilled Anthropic’s Fable, 22.07.2026. Quelle für die Äußerung von Finanzminister Scott Bessent und dafür, dass keine technischen Belege vorgelegt wurden.
- Offener Brief “Open Weights and American AI Leadership” vom 24.07.2026, mitgezeichnet unter anderem von OpenAI und Google. Quelle für die Bezeichnung von Distillation als weit verbreitetes Verfahren.