Kopieren statt Erfinden, Teil 2:
Was die Kopie kostet und was das Original
Im Dezember 2024 nannte das chinesische Unternehmen DeepSeek eine Zahl, die um die Welt ging. 5,576 Millionen Dollar habe das Training seines Modells V3 gekostet. Gemessen an den Beträgen, die aus dem Silicon Valley zu hören waren, klang das nach einem Bruchteil. An den Börsen geriet einiges in Bewegung.
Die Zahl stimmt. Sie bedeutet nur etwas anderes, als die meisten daraus gelesen haben.
Hier geht es um die Rechnung dahinter. Was kostet es, ein fremdes Modell über seine API abzuschöpfen? Was kostet es, ein eigenes zu bauen? Und warum ist die Antwort in beiden Fällen nicht der Betrag, den man erwartet? Am Ende steht eine Frage, die deutlich älter ist als die künstliche Intelligenz. Ob es sich überhaupt lohnt, der Erste zu sein.
Für alle, die den ersten Teil nicht gelesen haben, in zwei Sätzen. Distillation heißt, ein fertiges Modell mit vielen Fragen zu behelligen und ein eigenes, kleineres auf dessen Antworten zu trainieren. Sie überträgt eine Fähigkeit, ohne sie neu zu erzeugen.
Was das Abschöpfen selbst kostet
An dieser Stelle stellt sich eine Frage, die in der Debatte selten auftaucht. Wer über eine API destilliert, muss das fremde Modell benutzen. Jede Anfrage kostet Geld. Wie viel eigentlich?
Die Rechnung lässt sich mit belegten Größen aufstellen. Was man braucht, ist eine Sammlung von Fragen samt der Antworten, die das große Modell darauf gibt. Stanfords Alpaca-Projekt kam 2023 mit 52.000 solcher Paare aus und zahlte dafür weniger als 500 Dollar. Für die Übertragung von Denkfähigkeit in kleinere Modelle nutzte DeepSeek 800.000 sorgfältig ausgewählte Beispiele, allerdings aus dem eigenen Modell erzeugt.
Wie teuer das wird, hängt daran, was das fremde Modell überhaupt herausgibt. Nehmen wir als Maßstab ein aktuelles Spitzenmodell, Fable 5 von Anthropic. Abgerechnet wird in Token. So heißen die Bruchstücke, in die ein Modell Text zerlegt, meist eine Silbe oder ein kurzes Wort. Nach Listenpreis kostet Fable 5 zehn Dollar je Million Token in der Anfrage und fünfzig Dollar je Million in der Antwort. Rechnet man mit 2.000 Token je Antwort, kommen 800.000 Beispiele auf rund 1,6 Milliarden Token und damit auf etwa 80.000 Dollar.
Das ist eine Beispielrechnung mit gesetzten Annahmen. Sie bewegt sich in beide Richtungen. Nach unten zieht die Batch API, bei der gesammelte Anfragen zum halben Preis abgerechnet werden. Nach oben zieht der Ausschuss, denn man erzeugt deutlich mehr Antworten, als man behält. DeepSeek behielt beim Aufbau seiner Beispiele nur die richtigen. Dort fiel das Verworfene als eigene Rechenzeit an. Wer über eine fremde API arbeitet, bezahlt es je Token mit.
Für den interessanteren Fall trägt die Rechnung ohnehin nicht. Sie bepreist fertige Antworten. Wer Denkfähigkeit übertragen will, braucht aber nicht das Ergebnis, sondern den Weg dorthin, und den gibt Fable 5 nicht heraus. Das Modell denkt immer, die Reasoning-Schritte werden auch abgerechnet, zurück kommt allenfalls eine Zusammenfassung. Man bezahlt für etwas, das man nicht bekommt. Wer den Gedankengang über die Frageformulierung doch herausziehen will, landet bei diesem Modell in einer eigenen Ablehnungskategorie.
Wer Denkfähigkeit abschöpfen will, findet dort also nicht das Material, das er dafür bräuchte.
Ein Vergleichswert macht die Größenordnung greifbar. DeepSeek erzeugte dieselben 800.000 Beispiele selbst, auf eigener Hardware, und zahlte dafür rund 10.000 Dollar. Wer sie bei einem fremden Anbieter einkauft, zahlt nach der Rechnung oben etwa das Achtfache. Teuer wird das Abschöpfen also nicht durch die Menge. Teuer wird es dadurch, dass man fremde Listenpreise zahlt statt eigener Stromrechnungen.
Gemessen am Pre-Training bleibt es dennoch wenig. Selbst wenn man den Ausschuss großzügig einrechnet und beim Mehrfachen der obigen Zahl landet, kostet das Abschöpfen nur wenige Prozent dessen, was das Original gekostet hat.
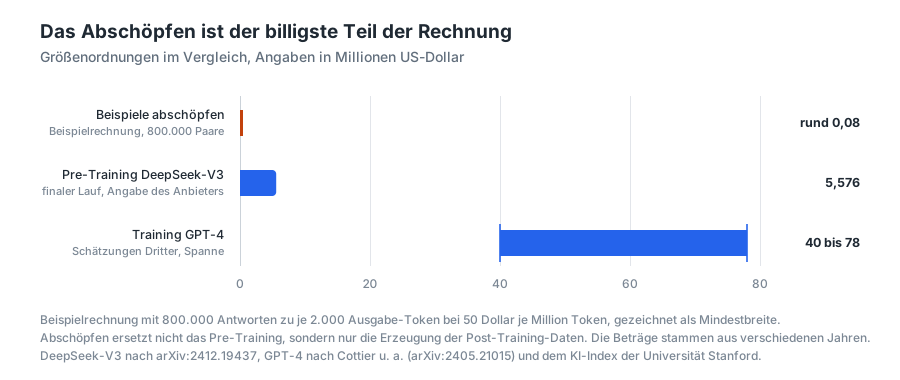
Nur ersetzt dieser Betrag eben nicht das Pre-Training, sondern die Erzeugung hochwertiger Post-Training-Daten. Darin steckt die eigentliche Arbeit, nämlich herauszufinden, wie gute Trainingsbeispiele überhaupt aussehen. Diese Arbeit liegt in den Antworten des Lehrers bereits vor.
Wie groß dieser Anteil ist, hat das Forschungsinstitut Epoch AI im März 2026 nachgerechnet. Bei OpenAI entfallen auf den finalen Trainingslauf nur 9,6 Prozent der gesamten Rechenleistung für Forschung und Entwicklung. Der ganze Rest steckt in Versuchen, mit denen sich herausfinden lässt, welche der vielen denkbaren Forschungsrichtungen im großen Maßstab trägt. Wer ein fertiges Modell abschöpft, umgeht also nicht die Rechenleistung. Er umgeht die Suche.
Die eigentlichen Hürden sind deshalb auch nicht die Token-Preise. Es sind Rate Limits, die den Durchsatz drosseln, Erkennungsmechanismen auf Anbieterseite und Nutzungsbedingungen, die das Abschöpfen für eigene Trainingszwecke meist verbieten.
Genau darauf zielt ein Vorwurf gegen das chinesische Unternehmen Moonshot. Michael Kratsios, Technologiebeauftragter der US-Regierung, schrieb im Juli 2026 auf X, dort sei eine eigene Plattform gebaut worden, um in großem Maßstab und mit wechselnden Zugängen abzuschöpfen. Belege legte er nicht vor. In der Auseinandersetzung zwischen amerikanischen und chinesischen Anbietern ist er selbst Partei.
Wo die Kosten wirklich liegen
Hier lohnt sich der genaue Blick, weil in der öffentlichen Debatte zwei sehr unterschiedliche Zahlen durcheinandergeraten.
Ein Sprachmodell entsteht in zwei Schritten. Zuerst das Pre-Training: Das Modell liest Billionen Token und lernt dabei Sprache. Hier entsteht das Fundament. Hier lag lange auch der ganz überwiegende Teil der Kosten. Danach das Fine-Tuning: Das Modell lernt, sich zu verhalten, Anweisungen zu befolgen, in einem bestimmten Ton zu antworten. Bei den heutigen Reasoning-Modellen kommt in diesem zweiten Schritt ein eigenständiges Training über Versuch und Belohnung hinzu. Es verschlingt selbst erhebliche Rechenleistung und bringt nachweislich neue Fähigkeiten hervor. Das einfache Fine-Tuning auf fertigen Antworten ist dagegen billig.
Entscheidend ist, wie oft welcher Schritt anfällt. Das Pre-Training passiert einmal und erzeugt ein Basismodell. Darauf können beliebig viele Modelle aufsetzen, jedes mit eigenem Fine-Tuning. DeepSeek machte aus seinem Basismodell V3 das Reasoning-Modell R1, Meta veröffentlicht Llama und Tausende trainieren darauf weiter. Eine wirklich neue Modellgeneration braucht dagegen ein neues Pre-Training, weil sich Architektur und Datenmenge ändern. Grundwissen lässt sich einem fertigen Modell nicht einfach nachschieben, es verlernt dabei Altes.
Distillation kann an beiden Schritten ansetzen. Wer sein eigenes Modell verkleinert, tut das oft schon im Pre-Training, so wie Google bei Gemma 2 und Nvidia bei Minitron. Wer ein fremdes, geschlossenes Modell über eine API abschöpft, kommt dort nicht heran. Für ihn bleibt nur der zweite Schritt.
Damit lässt sich die Frage beantworten, um die es hier eigentlich geht. Was genau spart, wer destilliert?
Das Pre-Training spart er nicht. Es muss stattgefunden haben, sonst gibt es kein Modell, auf dem sich aufbauen ließe. Bezahlt hat es nur jemand anderes. Wer Llama oder Qwen herunterlädt, bekommt ein fertig vortrainiertes Modell, für das Meta oder Alibaba Millionen ausgegeben haben. Verschenkt ist aber nicht dasselbe wie eingespart. Die Kosten sind angefallen, sie stehen nur in einer fremden Bilanz.
Gespart wird der zweite Schritt, genauer der teure Teil davon. Einem Modell das Denken beizubringen, kostet Reinforcement Learning und davor sehr viel Forschung. Wer die fertigen Reasoning-Spuren abschöpft und ein Modell per Fine-Tuning darauf trainiert, überspringt beides.
Bei DeepSeek lassen sich beide Seiten beobachten. Für das eigene Reasoning-Modell R1 sparte das Unternehmen nichts. Es bezahlte das Pre-Training von V3 mit 5,576 Millionen Dollar und das Reinforcement Learning mit weiteren 294.000. Bei den sechs kleinen Modellen, die es anschließend veröffentlichte, sah die Rechnung anders aus. Dafür lud DeepSeek offene Modelle von Meta und Alibaba herunter, deren Pre-Training diese Unternehmen bezahlt hatten. Die Reasoning-Spuren lagen aus dem eigenen Projekt bereits vor. Übrig blieben zwei bis drei Epochen.
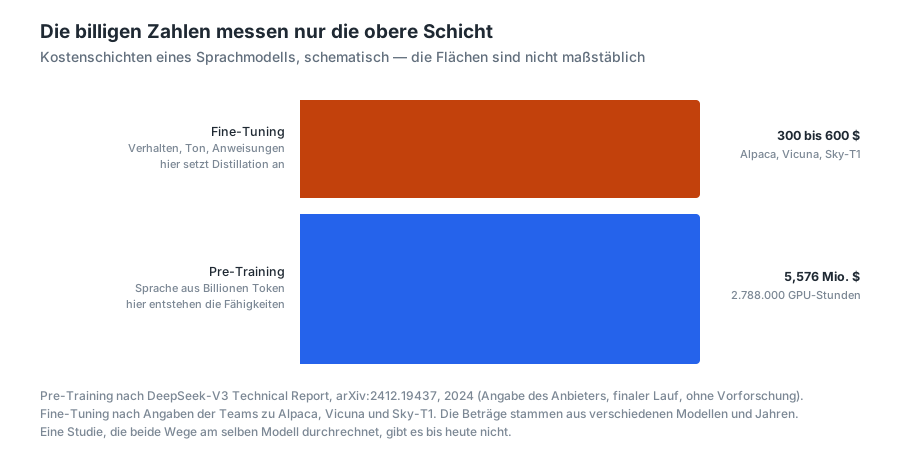
Die berühmten Billigzahlen stammen alle aus diesem zweiten Schritt. Das Stanford-Projekt Alpaca kam 2023 auf unter 600 Dollar, von denen knapp 500 auf die Datenerzeugung entfielen und der Rest auf das Training. Vicuna kam im selben Jahr auf rund 300, das Berkeley-Projekt Sky-T1 Anfang 2025 auf rund 450. Alle drei Angaben stammen von den Teams selbst und sind öffentlich dokumentiert.
Zitiert werden diese Zahlen bis heute, wenn von billiger Distillation die Rede ist. Sie gelten allerdings für Modelle zwischen sieben und zweiunddreißig Milliarden Parametern und für Datensätze von 17.000 bis 52.000 Beispielen. Wer die Denkfähigkeit eines heutigen Spitzenmodells überträgt, arbeitet mit 800.000 Beispielen und liegt allein beim Datenteil im fünfstelligen Bereich. Die Dreihundert-Dollar-Ära ist vorbei. Dazu kommt, dass alle drei Projekte ein bereits vortrainiertes offenes Basismodell voraussetzen, dessen Kosten in diesen Zahlen nicht auftauchen.
Auf der anderen Seite die Größenordnung des Pre-Trainings. DeepSeek nannte für sein Modell V3 einen Betrag von 5,576 Millionen Dollar, gerechnet aus 2,788 Millionen GPU-Stunden zu einem angenommenen Mietpreis von zwei Dollar. Diese Zahl ging als Sensation um die Welt. Im Paper selbst steht allerdings ein Satz, der in der Berichterstattung meist fehlte. Die Summe umfasse ausschließlich das offizielle Training und schließe Vorforschung sowie Ablationsexperimente ausdrücklich aus. Das sind Testläufe, bei denen einzelne Bestandteile des Modells weggelassen werden, um zu messen, was sie überhaupt beitragen. Die Analysefirma SemiAnalysis schätzte die gesamten Serverinvestitionen des Unternehmens später auf rund 1,6 Milliarden Dollar.
Für westliche Spitzenmodelle liegen die Schätzungen ähnlich weit auseinander. Eine Arbeitsgruppe um Ben Cottier beziffert das Training von GPT-4 auf rund 40 Millionen Dollar und verteilt dabei Anschaffung und Energieverbrauch der Hardware über deren Lebensdauer. Der KI-Index der Universität Stanford kommt auf rund 78 Millionen, weil er den vorliegenden Berichten zufolge mit Cloud-Mietpreisen rechnet, in denen eine Gewinnmarge steckt. Gleiche Datenbasis, fast doppelter Betrag. Die Bandbreite ist hier die eigentliche Aussage.
Bleibt die Frage, warum DeepSeek so viel billiger davonkam. Der naheliegende Verdacht lautet, sie hätten abgeschöpft. Belegt ist er nicht. OpenAI erklärte im Januar 2025, es gebe Hinweise auf massenhafte Abfragen über die eigene API, legte aber weder Daten noch Methodik vor. Was DeepSeek im eigenen Paper beschreibt, sind Effizienzgewinne an der Architektur. Das Modell aktiviert pro Anfrage nur einen kleinen Teil seiner Bestandteile, und es wurde in halbierter Zahlengenauigkeit trainiert. Dazu kommt der Zeitpunkt. Zwischen GPT-4 und V3 liegen anderthalb Jahre Fortschritt bei Hardware und Verfahren. Der politische Streit über den Verdacht füllt den dritten Teil.
Eine Studie, die beide Wege am selben Modell sauber gegenrechnet, gibt es bis heute nicht. Alle belastbaren Zahlen stammen aus Laborumgebungen, in denen ein Anbieter seine eigenen Modelle verkleinert. Nvidia berichtet für Minitron von bis zu vierzigmal weniger Trainingsdaten. Als Größenordnung taugt das, als sauberer Vergleich nicht.
Die Ökonomie dahinter ist älter als die KI
Ab hier geht es nicht mehr um Kosten, sondern um Markterfolg. Die Zahlen wechseln entsprechend von Dollar zu Prozent.
Die Frage, ob sich Nachahmen lohnt, ist nämlich keine Erfindung des KI-Zeitalters. Die Innovationsökonomie untersucht sie seit den achtziger Jahren. Ihre Befunde sind unbequem für jeden, der auf den Vorsprung des Ersten setzt.
Marvin Lieberman und David Montgomery schrieben 1988 die maßgebliche Arbeit über Pioniervorteile und überprüften sie zehn Jahre später selbst. Das Ergebnis dieser Nachprüfung fällt ernüchternd aus.
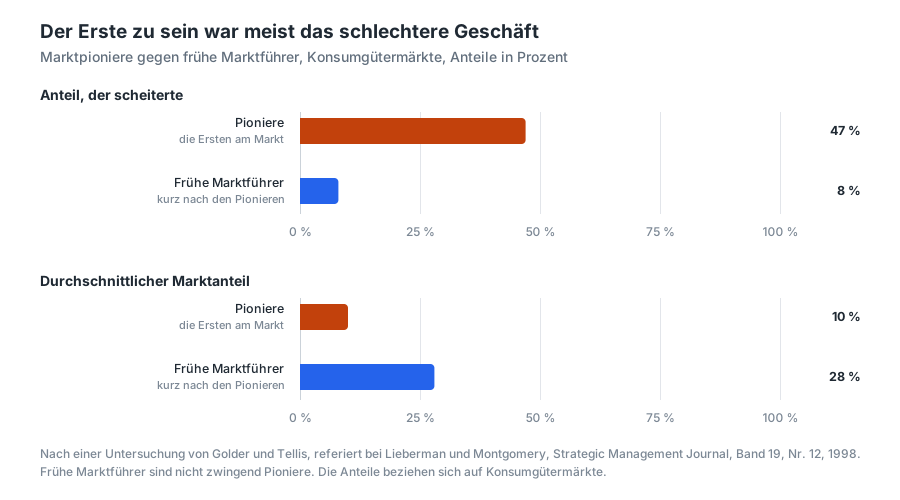
Die Zahlen stammen aus einer Untersuchung von Golder und Tellis, die Lieberman und Montgomery referieren. Von den echten Pionieren scheiterten 47 Prozent. Die frühen Marktführer, die kurz nach ihnen kamen, scheiterten in 8 Prozent der Fälle und hielten am Ende fast dreimal so viel Marktanteil.
Ein Vorbehalt gehört dazu. Die Autoren nennen ihn selbst. Frühe Marktführer sind über ihren Erfolg definiert, Pioniere über den Zeitpunkt ihres Eintritts. Ein Teil des Abstands steckt damit schon in der Einteilung. Die Botschaft ist deshalb nicht, dass Pioniere immer verlieren. Sie ist, dass der Vorsprung sich nicht von selbst hält.
Womit er sich hält, hat David Teece 1986 beschrieben. Sein Beispiel ist der Computertomograf. Die britische Firma EMI hat ihn erfunden und binnen sechs Jahren die Führung verloren, nicht weil die Konkurrenz die bessere Technik gehabt hätte, sondern weil sie Fertigung, Vertrieb und Servicenetz für den Krankenhausmarkt besaß. Teece nennt das komplementäre Vermögenswerte. Lässt sich eine Erfindung leicht kopieren, entscheidet nicht sie über den Gewinn, sondern wer alles Übrige kontrolliert. Wer heute nach so einem Fall sucht, landet bei Google: eigene Chips, eigene Rechenzentren, die Suche, Android, ein Cloud-Geschäft mit Bestandskunden. Wer ein gleichwertiges Modell abschöpft, hat von alldem nichts.
Ob dieses Prinzip eins zu eins auf Sprachmodelle passt, ist offen. Förmlich auf große KI-Modelle angewendet hat diese Literatur noch niemand. Pierre Azoulay und Kollegen haben es 2024 in einem nicht begutachteten Working Paper übertragen und erwarten eine stark konzentrierte Marktstruktur, weil die etablierten Anbieter genau diese Vermögenswerte halten. Mehr als eine Denkfigur ist das nicht. Die trägt aber.
Was bleibt
Drei Zahlen tragen diesen Teil.
Ein Reasoning-Modell von Grund auf zu bauen kostete DeepSeek rund 5,9 Millionen Dollar, davon 5,576 Millionen für das Pre-Training von V3 und 294.000 für das Reinforcement Learning. Dieselbe Fähigkeit über eine fremde API abzuschöpfen kostet nach der Rechnung oben etwa 80.000 Dollar. Das sind anderthalb Prozent.
Diese Zahl täuscht allerdings, weil ein Nachahmer das Pre-Training ohnehin nie bezahlt hätte. Er lädt ein offenes Modell herunter, für das Meta oder Alibaba aufgekommen sind. Der ehrliche Vergleich lautet deshalb anders. Wer die Denkfähigkeit selbst erforscht, zahlt 294.000 Dollar, wer sie abschöpft, rund 80.000. Das ist eine Ersparnis von gut siebzig Prozent.
Die dritte Zahl erklärt, warum auch das noch zu günstig gerechnet ist. Nach der Auswertung von Epoch AI entfallen auf den finalen Trainingslauf bei OpenAI nur 9,6 Prozent der Rechenleistung für Forschung und Entwicklung. Über neunzig Prozent stecken in den Versuchen davor, also in der Suche nach dem, was überhaupt trägt. Diese Suche taucht in keiner der genannten Summen auf. Ein Nachahmer bekommt sie geschenkt.
Damit erklärt sich, was am Markt zu beobachten ist. Ein leistungsfähiges Reasoning-Modell kostet keine Millionen mehr, sondern einen mittleren fünfstelligen Betrag, sobald ein Anbieter das Basismodell verschenkt und ein zweiter die Reasoning-Spuren liefert. Wer heute klagt, dass die Nachbauten zu schnell kommen, klagt im Grunde über eine Kostenstruktur.
Ob es sich lohnt, der Erste zu sein, entscheidet sich damit nicht an der Erfindung. Es entscheidet sich an dem, was um sie herum steht.
Im dritten Teil geht es um den politischen Streit über das Abschöpfen, um die auffällig fehlenden Gerichtsverfahren und um die Frage, warum Europa diesen Weg nicht geht.
Quellen
- DeepSeek-AI: DeepSeek-R1. Incentivizing Reasoning Capability in LLMs via Reinforcement Learning. In: Nature, Band 645, 2025, S. 633–638. https://doi.org/10.1038/s41586-025-09422-z
- DeepSeek-AI: DeepSeek-V3 Technical Report. Preprint, arXiv:2412.19437, 2024. Angabe des Anbieters über eigene Kosten. https://arxiv.org/abs/2412.19437
- Ben Cottier u. a.: The rising costs of training frontier AI models. Preprint, arXiv:2405.21015, 2024. https://arxiv.org/abs/2405.21015
- Saurav Muralidharan u. a.: Compact Language Models via Pruning and Knowledge Distillation. Preprint, arXiv:2407.14679, 2024. https://arxiv.org/abs/2407.14679
- Anthropic: Batch processing. Entwicklerdokumentation, abgerufen am 01.08.2026. Quelle für den Batch-Rabatt von 50 Prozent. https://platform.claude.com/docs/en/docs/build-with-claude/batch-processing
- David J. Teece: Profiting from technological innovation. In: Research Policy, Band 15, Nr. 6, 1986, S. 285–305. https://doi.org/10.1016/0048-7333(86)90027-2
- Marvin B. Lieberman, David B. Montgomery: First-mover advantages. In: Strategic Management Journal, Band 9, Nr. S1, 1988, S. 41–58. https://doi.org/10.1002/smj.4250090706
- Marvin B. Lieberman, David B. Montgomery: First-mover (dis)advantages. Retrospective and link with the resource-based view. In: Strategic Management Journal, Band 19, Nr. 12, 1998, S. 1111–1125. https://doi.org/10.1002/(SICI)1097-0266(1998120)19:12%3C1111::AID-SMJ21%3E3.0.CO;2-W
- Peter N. Golder, Gerard J. Tellis: Untersuchung zu Marktpionieren und frühen Marktführern in Konsumgütermärkten. Im Text ausschließlich nach der Wiedergabe bei Lieberman und Montgomery (1998) zitiert, die Originalarbeit wurde nicht eingesehen.
- Rohan Taori u. a.: Alpaca. A Strong, Replicable Instruction-Following Model. Stanford CRFM, 2023. Kostenangabe des Teams. https://crfm.stanford.edu/2023/03/13/alpaca.html
- LMSYS: Vicuna. An Open-Source Chatbot Impressing GPT-4. 2023. Kostenangabe des Teams. https://lmsys.org/blog/2023-03-30-vicuna/
- NovaSky, UC Berkeley: Sky-T1. Train your own O1 preview model within $450. 2025. Kostenangabe des Teams. https://novasky-ai.github.io/posts/sky-t1/
- Stanford HAI: AI Index Report 2025. Die Kostenangabe zu GPT-4 ist hier nur über übereinstimmende Sekundärberichte belegt, nicht wörtlich aus dem Primärdokument.
- SemiAnalysis: Schätzung der Infrastrukturkosten von DeepSeek. Nur über Presseberichte belegt, der Originalbericht wurde nicht eingesehen.
- Pierre Azoulay, Joshua Krieger, Abhishek Nagaraj: Old Moats for New Models. Openness, Control, and Competition in Generative AI. NBER Working Paper 32474, 2024. Nicht begutachtet. https://doi.org/10.3386/w32474
- Jean-Stanislas Denain, Cheryl Wu: Final training runs account for a minority of R&D compute spending. Epoch AI, 23.03.2026. Quelle der Angabe von 9,6 Prozent. https://epoch.ai/gradient-updates/r-and-d-vs-training-compute
- OpenAI: Stellungnahme zum Verdacht unerlaubter Abfragen durch DeepSeek, Januar 2025. Von mehreren Medien übereinstimmend wiedergegeben, im Wortlaut vorsichtig gehalten. Belege wurden bis heute nicht veröffentlicht.
- Michael Kratsios: Beitrag auf X vom 22.07.2026 (@mkratsios47). Einzige Quelle für den Vorwurf gegen Moonshot. Eine politische Aussage ohne vorgelegte Belege, im Text entsprechend gekennzeichnet. https://x.com/mkratsios47/status/2079933645888880708