Kopieren statt Erfinden, Teil 3:
Der Vorwurf, die fehlende Klage und Europa
Das Weiße Haus warf dem chinesischen Unternehmen Moonshot am 22. Juli vor, ein amerikanisches Modell abgeschöpft zu haben. Bis heute liegt kein technischer Beleg dafür vor. Bemerkenswerter ist etwas anderes: Seit anderthalb Jahren erheben amerikanische Labore diesen Vorwurf regelmäßig, mit Namen, Zahlen und forensischen Details. Bekannt geworden ist bis heute keine einzige Klage.
Hier geht es um den Streit selbst. Was ist an dem Vorwurf dran, was liegt an Belegen vor und warum wird die Sache vor Kongressausschüssen ausgetragen statt vor Gericht? Daran schließt eine zweite Frage an: China hält mit den USA mit, auch weil es abschöpft. Warum macht Europa das nicht?
Wer die ersten beiden Teile nicht kennt, braucht für diesen nur eines zu wissen. Distillation heißt, ein fertiges Modell abzufragen und ein eigenes auf dessen Antworten zu trainieren. Sie überträgt Fähigkeit sehr effizient, erzeugt aber keine neue. Und sie setzt voraus, dass jemand anders das teure Pre-Training bereits bezahlt hat.
Was der aktuelle Stand hergibt
Hat Moonshot nun abgeschöpft?
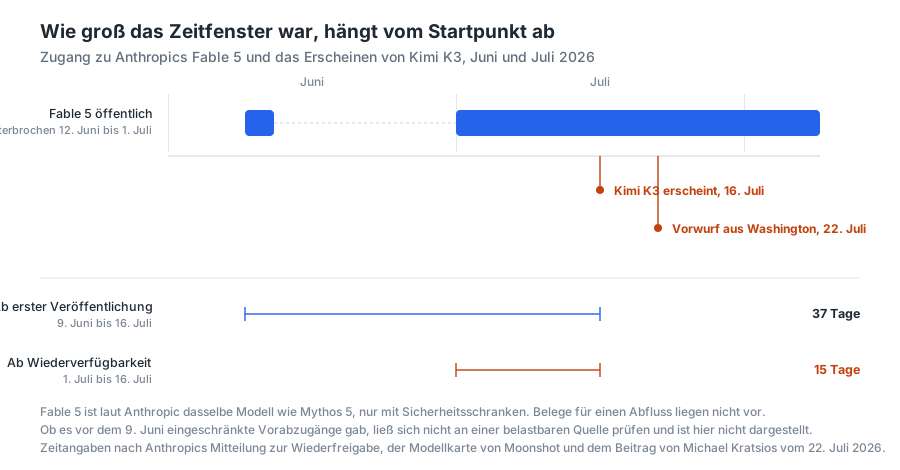
Die naheliegende Entgegnung lautet, dafür sei die Zeit zu knapp gewesen. Sie trägt nicht. Kolportiert werden zwei Wochen, gerechnet ab dem 1. Juli, als Fable 5 nach einer Unterbrechung wieder global verfügbar war. Erschienen ist das Modell schon am 9. Juni, drei Tage bevor eine Exportanordnung es offline nahm. Bis zum Erscheinen von Kimi K3 am 16. Juli sind das 37 Tage, nicht fünfzehn.
Und auch das ist der enge Schnitt. Fable 5 stammt aus derselben Familie wie Claude Mythos. Und Mythos war seit dem 7. April über ein Partnerprogramm mit echtem API-Zugang draußen, ab dem 2. Juni bei rund 150 Organisationen. Wer dort Zugang hatte, konnte gut hundert Tage sammeln. Ob Moonshot dazugehörte, ist nicht belegt.
Damit verschiebt sich die Frage, statt sich zu erledigen. Ein Modell mit 2,8 Billionen Parametern lässt sich in 37 Tagen nicht von Grund auf trainieren. Möglich wäre ein nachträgliches Fine-Tuning auf abgeschöpften Antworten. Das ist etwas grundlegend anderes als ein Nachbau. Es würde erklären, warum ein Modell in bestimmten Leaderboards stark abschneidet, ohne dass seine Grundfähigkeiten von woanders stammen müssten.
Dagegen spricht ein technisches Detail, das in der Debatte kaum vorkommt. Fable 5 gibt seinen ausgeschriebenen Gedankengang nicht heraus. Das Modell denkt, die Reasoning-Schritte werden abgerechnet, zurück kommt nur das Ergebnis. Wer Denkfähigkeit abschöpfen wollte, fände dort nicht das Material dafür. In Teil 1 stand es so: Wer ein Reasoning-Modell verkauft, muss diese Schritte ausliefern. Fable 5 zeigt, dass die Annahme so nicht stimmt.
Das Argument sperrt allerdings nur einen Weg, nicht die Sache. Wer die Denkschritte mit einem offenen Modell selbst erzeugt, kann Fable als Antwortschlüssel benutzen und nur die Durchläufe behalten, die zum richtigen Ergebnis führen. Und Kimi K3 zeigt seine Stärke beim Frontend-Programmieren, wo die fertige Antwort schon das Trainingsmaterial ist.
Dazu kommt ein Detail, das die Erzählung verkompliziert. Anthropic hatte Moonshot schon im Februar 2026 Distillation vorgeworfen, als es Fable noch gar nicht gab. Der Vorwurf ist älter als das Modell, um das es jetzt geht.
Nichts davon entlastet Moonshot. Es fehlen schlicht die Belege, in beide Richtungen. Das Weiße Haus hat keine vorgelegt, Peking hat die Vorwürfe zurückgewiesen.
Was vorliegt, ist Forensik über Zugriffe, ermittelt über Adressmuster, Metadaten und Zahlungswege. Der oft zitierte Brief an einen Senatsausschuss vom Juni nennt 28,8 Millionen Austausche über fast 25.000 gefälschte Konten. Diese Zahl gehört allerdings nicht zu Moonshot. Sie betrifft nach Anthropics eigener Darstellung Akteure aus dem Umfeld von Alibaba. Für Moonshot steht die ältere Erhebung vom Februar mit rund 3,4 Millionen Austauschen über das reguläre Claude-Angebot, nicht über Fable oder Mythos. Das ist ernstzunehmende Arbeit, sie belegt aber Zugriff, nicht Verwendung. Kein Dokument zeigt, dass diese Antworten in ein Training eingegangen sind statt in eine Auswertung. OpenAI formuliert das gegenüber dem Kongress selbst nur als vereinbar mit Distillation.
Und dann ist da eine Auffälligkeit, die über die Rechtslage mehr aussagt als jedes Gutachten. Bekannt geworden ist bis heute keine einzige Klage.
Das ist ein Rechercheergebnis und kein Beweis, dass es keine gibt. Gerichtsregister habe ich nicht abgefragt. Die Aussage stützt sich auf öffentliche Dokumente. Die Rechtswissenschaftler Peter Henderson und Mark Lemley stellten Ende 2024 fest, dass abgesehen von gesperrten Konten kein Anbieter je versucht habe, diese Klauseln durchzusetzen. In OpenAIs Eingabe an einen Kongressausschuss vom Februar 2026 ist von Klage, Unterlassung oder Schadensersatz nirgends die Rede. Und Anthropic benennt in seinem Brief vom Juni den Verstoß gegen die eigenen Nutzungsbedingungen ausdrücklich und fordert danach nicht Schadensersatz, sondern Gesetzgebung.
Wenn der Vertragsweg trüge, wäre er der schnellere und billigere. Dass zwei der drei größten amerikanischen Labore stattdessen an Kongressausschüsse schreiben und neue Befugnisse verlangen, ist die eigentliche Nachricht.
Dazu eine Spannung, die selten auffällt. Zwei Tage nach dem Vorwurf aus Washington zeichnete OpenAI einen offenen Brief mit, der Distillation als verbreitetes Verfahren verteidigt und vor pauschalen Beschränkungen warnt. Fünf Monate zuvor hatte dasselbe Unternehmen dem Kongress dargelegt, die beobachteten Zugriffsmuster seien mit Distillation vereinbar, als Teil einer Eingabe für schärfere Kontrollen. Beides steht in lesbaren Dokumenten.
Über den Einzelfall hinaus zählt die Lage insgesamt. Kimi K3 steht auf Rang vier des Intelligenz-Index von Artificial Analysis, hinter Fable 5 und GPT-5.6 Sol.
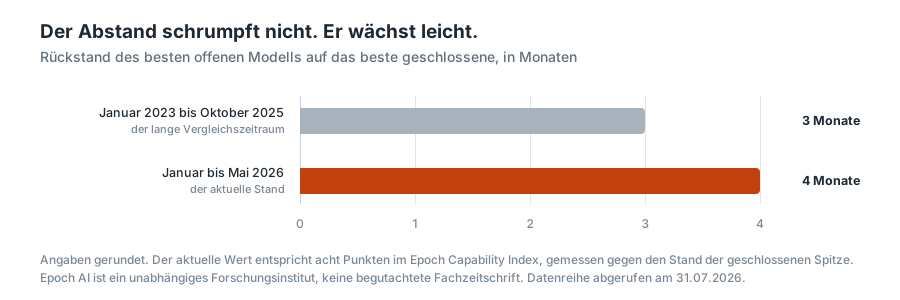
Epoch AI misst laufend, wie weit das beste frei verfügbare Modell hinter dem besten geschlossenen liegt, umgerechnet in Monate. Von Januar 2023 bis Oktober 2025 waren es rund drei, für 2026 rund vier. Der Abstand schrumpft also nicht. Er wächst leicht.
Und noch ein Detail gehört zum Bild. Kimi K3 steht unter einer eigenen Lizenz, die ab einer Umsatzschwelle greift, nicht unter einer freien. Offene Gewichte heißen hier nicht freie Verwendung.
Legt man diese Zahlen nebeneinander, werden zwei Rennen sichtbar. China führt dort, wo gezählt wird. Knapp ein Viertel aller KI-Publikationen stammt von dort, bei den Patentanmeldungen sind es fast siebzig Prozent. Chinesische Modelle kommen inzwischen auf mehr Abrufe bei Hugging Face als amerikanische. Auf der Vermittlungsplattform OpenRouter stieg ihr Anteil an den tatsächlich abgerufenen Token in vierzehn Monaten von 2,8 auf über siebzig Prozent. Die Vereinigten Staaten führen dort, wo ausgewählt wird. Jedes Modell an der Fähigkeitsspitze stand seit 2023 dort. Beim Rechenbestand halten fünf amerikanische Anbieter über siebzig Prozent. Beim Personal dasselbe Muster: Achtunddreißig Prozent der führenden KI-Forscher haben ihren Abschluss in China gemacht, gearbeitet wird dort von elf Prozent.
Daher rührt der Eindruck, beide Länder seien gleichauf. Für Breite und Verbreitung trifft er zu, für Spitze und Rechenleistung nicht. Für die Frage nach Europa ist das entscheidend, denn Europa steht in keiner der beiden Spalten.
Warum Europa nicht destilliert
Zwei Vermutungen liegen nahe. Liegt es am Recht? Oder will man es sich mit Washington nicht verderben?
Was bis hierhin stand, war Bestandsaufnahme. Was jetzt folgt, ist meine Einordnung. Ich kennzeichne, wo sie über die Belege hinausgeht.
Zuerst muss die Frage korrigiert werden, denn sie unterstellt, Europa habe keine eigenen Modelle. Mistral veröffentlichte im Dezember 2025 ein Modell mit 675 Milliarden Parametern. Fraunhofer trainierte Teuken-7B in allen 24 EU-Amtssprachen auf dem Jülicher Rechner JUWELS. Aleph Alpha baute sein Modell Pharia auf 7,7 Billionen Token. Alle drei sind von Grund auf trainiert, keines ist ein Nachbau.
Es fehlt nicht am Modell. Es fehlt an der Spitzenposition. Im Intelligenz-Index von Artificial Analysis liegt das beste europäische Modell bei etwa der Hälfte der amerikanischen Spitze. Für diesen Abstand gibt es eine Erklärung, die alles andere überwiegt.
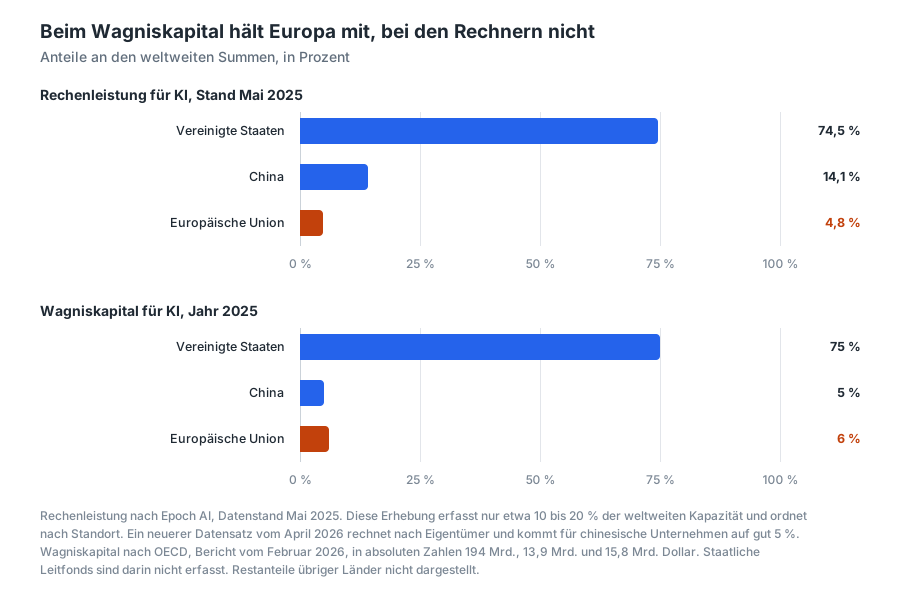
Wie groß Europas Anteil an der weltweiten KI-Rechenleistung genau ist, weiß niemand. Das Forschungsinstitut Epoch AI bezifferte ihn im Mai 2025 auf 4,8 Prozent und den amerikanischen auf 74,5. Diese Erhebung erfasste allerdings nur zehn bis zwanzig Prozent des Weltbestands und ordnete Rechner dem Standort zu, nicht dem Eigentümer.
Der aktuellere Datensatz vom April 2026 behebt beides. Er rechnet den Chipbestand nach Eigentümer zusammen und bezieht neben Nvidia und AMD auch Huawei ein. Fünf amerikanische Cloud-Anbieter halten darin über siebzig Prozent, allein Google rund ein Viertel, chinesische Unternehmen gut fünf.
Europa kommt in dieser Aufstellung nicht vor. Es taucht weder als Region noch mit einem einzelnen Unternehmen auf, sondern geht in einer Restgröße unter. Das ist zunächst eine Aussage über den Zuschnitt der Erhebung, die nach den größten Eigentümern fragt. Dass Europa dabei durchfällt, ist trotzdem der aussagekräftigste Befund dieses Abschnitts. Wer in der Bilanz der Rechenleistung keine eigene Zeile füllt, verhandelt über Zugang, nicht mehr über Bedingungen.
Der naheliegende Schluss lautet, Europa habe kein Geld. So einfach ist es nicht. Nach einer OECD-Auswertung entfielen 2025 rund sechs Prozent des weltweiten Wagniskapitals für KI auf die EU und fünf auf China, 15,8 gegen 13,9 Milliarden Dollar, während die USA auf 194 Milliarden kamen. Diese Zahl misst allerdings nur Wagniskapital. Die OECD schreibt den Vorbehalt selbst in ihren Bericht. Chinesische KI wird zu erheblichen Teilen über staatliche Leitfonds finanziert, die dort nicht auftauchen. Eine Stanford-Auswertung beziffert allein diesen Kanal auf rund 184 Milliarden Dollar. Bei der privaten Gesamtinvestition stehen nach dem AI Index 2026 285,9 Milliarden gegen 12,4. Der belastbare Befund lautet deshalb nicht, dass Europa mehr Geld hätte als China. Es setzt sein privates Kapital schlechter in Spitzenmodelle um.
Am Geld hapert es also nicht, an der Bündelung schon. Das europäische Rechnerprogramm EuroHPC verfügt über sieben Milliarden Euro für 2021 bis 2027, ein einziges Rechenzentrum von Meta kostete allein an Hardware rund achtzehn Milliarden Dollar. OpenEuroLLM, das Vorzeigeprojekt für ein europäisches Sprachmodell, arbeitet mit 37,4 Millionen Euro. Und bei den großen Ankündigungen zählt weniger die Summe als der Kalender: InvestAI wurde im Februar 2025 mit 200 Milliarden Euro angekündigt, der Baubeginn der ersten Großrechenanlage ist für 2027 vorgesehen. In diesen zwei Jahren hat sich die Rechenleistung an der Weltspitze mehrfach verdoppelt.
Dazu ein Engpass, der selten genannt wird. Ein großer Rechenverbund zieht 280 bis 300 Megawatt, so viel wie eine Viertelmillion europäischer Haushalte. Die europäischen Stromnetze gehören nach einer Analyse des Berliner Thinktanks interface zu den am stärksten ausgelasteten der Industrieländer, mit mehrjährigen Wartelisten für Netzanschlüsse. Nicht der Chip ist die Hürde, sondern die Steckdose.
Das Recht verbietet es nicht
Jetzt zur Rechtsfrage. Sie ist die verwickeltste Passage dieses Textes, deshalb vorab das Ergebnis: Kein Rechtsgebiet verbietet Distillation, weder in Europa noch in den USA. Was bleibt, ist eine Offenlegungspflicht und ein Prozessrisiko ohne Präzedenzfall. Wer das glaubt, kann den Rest dieses Abschnitts überspringen.
Der AI Act verbietet Distillation nicht. Nach meiner Lesart der Rechenregeln begünstigt er sie sogar. Die Kommission hat im Juli 2025 Leitlinien zu den Pflichten für Modellanbieter veröffentlicht. Darin steht ausdrücklich, dass der Rechenaufwand des Lehrermodells bei der Berechnung des eigenen Trainingsaufwands nicht mitzählt. Wer destilliert, erbt die Schwelle des Lehrers also nicht. Auch die viel zitierte Ein-Drittel-Regel greift beim Abschöpfen über eine API gar nicht. Sie besagt, dass man selbst zum Anbieter wird, wenn man ein fremdes Modell mit mehr als einem Drittel von dessen ursprünglichem Rechenaufwand weiterbaut. Das setzt voraus, dass man die fremden Gewichte in der Hand hat. Wer nur Antworten abfragt, hat sie nicht.
Eine Asymmetrie gibt es trotzdem, sie liegt woanders. Der Rechenaufwand für die Erzeugung synthetischer Daten zählt in den eigenen, einschließlich der verworfenen Beispiele: Wer hundert Antworten erzeugt und zehn behält, rechnet alle hundert an. Dazu verlangt der AI Act eine öffentliche Zusammenfassung der Trainingsinhalte, in der synthetische Daten aus anderen Modellen eigens auszuweisen sind. Nach der Lesart der Kanzlei WilmerHale gehört dazu die Benennung der Quellmodelle, den Wortlaut der amtlichen Vorlage habe ich nicht selbst geprüft.
Stimmt diese Lesart, ist das die einzige belegbare rechtliche Ungleichheit gegenüber China. Sie ist eine Offenlegungspflicht, kein Verbot. Sie erklärt nicht, warum Europa nicht destilliert, sondern warum Europa es nicht unbemerkt könnte.
Naheliegend wäre das Urheberrecht als zweite Schranke. Es trägt kaum. Rein maschinell erzeugte Modellausgaben sind nach amerikanischer Rechtsprechung nicht geschützt, weil das Gesetz einen menschlichen Urheber verlangt. Der Supreme Court hat die Revision dazu im März 2026 nicht angenommen. In der EU fehlt ein Urteil des EuGH, die vorherrschende Auffassung geht in dieselbe Richtung. Fehlt der Schutz, braucht es auch keine Schranke für Text und Data Mining. Und das Datenbankherstellerrecht greift ebenfalls nicht. Der EuGH schützt nur, wer Daten sammelt, nicht, wer sie erzeugt. Daraus folgt etwas Unerwartetes. Gerade weil die Ausgaben ungeschützt sind, kann der Anbieter ihre Verwendung vertraglich frei beschränken.
Damit landet auch dieser Weg beim Vertrag. Dort ist die Lage ungeklärt, allerdings anders, als man vermutet. Die Nutzungsbedingungen der amerikanischen Anbieter untersagen das Training konkurrierender Modelle. Der Stanford-Jurist Mark Lemley hält solche Klauseln für vermutlich nicht durchsetzbar, weil dahinter kein Immaterialgüterrecht steht und Gerichte reine Wettbewerbsverbote ungern erzwingen.
Eine verbreitete Annahme lohnt den genaueren Blick. Man hört oft, das Nachbauen fremder Technik sei geschützt, weil das Recht das Untersuchen eines Produkts erlaubt. Das amerikanische Geschäftsgeheimnisrecht nimmt Reverse Engineering tatsächlich vom Begriff der unlauteren Mittel aus. Die europäische Richtlinie erlaubt das Untersuchen ebenfalls, knüpft es aber an eine Bedingung: Eine wirksame Vertragspflicht darf nicht entgegenstehen. Ob eine Klausel in Nutzungsbedingungen eine solche Pflicht begründet, ist gerichtlich nicht geklärt. Das ist meine Lesart des Wortlauts.
Ein europäischer Nachteil folgt daraus trotzdem nicht. Auch in den USA schützt die Ausnahme nur vor dem Vorwurf des Geheimnisverrats, nicht vor einer Vertragsklage. Ein Bundesberufungsgericht hielt dort 2003 ein vertragliches Reverse-Engineering-Verbot für durchsetzbar. Ein Richter widersprach. Einheitlich ist die Rechtsprechung nicht. Beide Rechtsordnungen sind offen. Der Unterschied ist, dass die europäische Richtlinie den Vertragsvorbehalt im Wortlaut benennt. Die deutsche Umsetzung habe ich nicht geprüft.
Damit lässt sich die Ausgangsfrage genauer beantworten als zu Beginn. Ein rechtliches Verbot gibt es nicht, weder hier noch dort. Der AI Act begünstigt Distillation in der Rechnung sogar. Was bleibt, ist ein vertragsrechtliches Prozessrisiko ohne Präzedenzfall. Es besteht auf beiden Seiten des Atlantiks. Meine Vermutung, ausdrücklich als solche: Ein solches Risiko wirkt auf einen europäischen Konzernvorstand mit Rechtsabteilung anders als auf ein junges Unternehmen in Hangzhou. Belegen lässt sich das nicht.
Die zweite Vermutung lautet, man wolle es sich mit Washington nicht verderben. Dafür habe ich keinen Beleg gefunden. Kein Dokument, kein Zitat, keine Analyse. Belegt ist etwas Schwächeres und trotzdem Aufschlussreiches: Eine amerikanische Ausfuhrregel stufte Anfang 2025 auch EU-Staaten wie Portugal und Österreich in die mittlere von drei Vertrauensstufen ein. Das größte private KI-Labor Europas, Silo AI, gehört seit 2024 AMD. Aleph Alpha ging 2026 in einer Fusion auf, bei der die kanadische Seite rund neunzig Prozent hält. Mistral ist seit 2024 Partner von Microsoft. Das ist eine dokumentierte Abhängigkeit. Ein dokumentierter Verzicht auf Distillation ist es nicht.
Damit zu meiner eigentlichen Antwort.
Europa destilliert nicht, weil Distillation das europäische Problem nicht löst.
Distillation verdichtet eine Fähigkeit, die ein anderer erzeugt hat. Sie ersetzt das teure Pre-Training nicht, sie setzt es voraus. Wer damit einen Rückstand aufholen will, bekommt keinen Vorsprung, sondern einen dauerhaft nachlaufenden Rückstand. Er ist genau so weit hinten, wie der Weg vom fremden Modell zum eigenen Fine-Tuning lang ist. Wie lang dieser Weg ist, misst niemand direkt. Der Abstand zwischen offenen und geschlossenen Modellen, den Epoch AI auf drei bis vier Monate beziffert, ist die nächstliegende Näherung. Er misst allerdings den Fähigkeitsrückstand, nicht die Dauer eines Nachbaus.
Für China ist derselbe Weg trotzdem vernünftig, weil dort etwas anderes gilt. Es hat große Konzerne im Rücken, die Rechenzentren aus eigener Kasse bauen. Die Grundfähigkeit stellt es selbst her. Wer das kann, für den ist Abschöpfen eine Abkürzung im Fine-Tuning. Wer es nicht kann, für den wäre es die ganze Strategie. Und das ist keine.
Dazu gehört eine Feststellung, die im politischen Getöse untergeht. Die Unterstellung, China kopiere nur, ist empirisch falsch. Aus chinesischen Laboren stammen mehrere Bauteile des heutigen Handwerkszeugs. Ein Verfahren verkleinert den Zwischenspeicher eines Modells um über neunzig Prozent. Das Trainingsverfahren GRPO kommt beim Reinforcement Learning ohne ein zweites, bewertendes Modell aus und läuft heute in den Standardbibliotheken von Hugging Face und Nvidia, jeweils mit namentlicher Quellenangabe. Eine Aufmerksamkeitsarchitektur erhielt 2025 den Preis für den besten Beitrag der wichtigsten Fachkonferenz für Sprachverarbeitung.
Umgekehrt gilt dasselbe. Die Vorhersage mehrerer Token auf einmal stammt von Meta, zwei weitere gängige Bauteile nach einer verbreiteten Architekturanalyse von Microsoft sowie von Nvidia und dem MIT, was ich nur an dieser Sekundärquelle geprüft habe. Der Wissensfluss geht in beide Richtungen. Was bleibt, ist ein Abstand. Nach den Messungen von Epoch AI stand seit 2023 jedes Modell an der Fähigkeitsspitze in den Vereinigten Staaten, chinesische Modelle lagen im Mittel sieben Monate dahinter.
Ein Gegenbeispiel spricht gegen jede Erzählung vom europäischen Unvermögen. Black Forest Labs aus Freiburg gehört bei Bildmodellen zur Weltspitze, bewertet mit 3,25 Milliarden Dollar. Bildmodelle sind um Größenordnungen billiger zu trainieren. Dort, wo die Kapitalschranke nicht greift, hält Europa mit.
Es liegt also nicht am Können und nicht am Recht.
Entschieden wird es an der Rechenleistung.
Was daraus folgt
Für Unternehmen, die KI einsetzen statt sie zu bauen, ergeben sich daraus drei nüchterne Schlüsse.
Der erste betrifft die Auswahl. Wenn ein nachgebautes Modell den Stil des Originals übernimmt, aber nicht dessen Zuverlässigkeit, dann taugen Leaderboards und Blindvergleiche nur begrenzt als Entscheidungsgrundlage. Beide messen bevorzugt, was Nachahmung gut überträgt. Wer auswählt, sollte an den eigenen Aufgaben testen.
Der zweite betrifft den Preis. Der Wettbewerb durch destillierte Modelle drückt die Kosten pro Anfrage, ein echter Vorteil für Anwender. Er hängt allerdings daran, dass die teure Erstentwicklung weiterläuft. Darüber entscheidet der Markt für Kopien nicht. Es entscheidet sich daran, ob sich die nächste Stufe für ihre Entwickler noch rechnet.
Der dritte betrifft die Abhängigkeit. Bindend wirkt die Architektur drumherum, nicht das Modell selbst. APIs, Datenflüsse, eingespielte Abläufe. Das ist nicht dasselbe wie die komplementären Vermögenswerte, um die es bei David Teece in Teil 2 ging: Bei ihm zählen die Vermögenswerte des Anbieters, hier die Wechselkosten des Anwenders. Ein Modell lässt sich austauschen. Eine Architektur, die um ein bestimmtes Modell herum gewachsen ist, nicht.
Für die Politik ist der Befund unbequemer. Exportkontrollen zielen auf Chips, also auf Gegenstände. Distillation braucht keine Gegenstände, sie braucht einen Zugang und Zeit. Wer den Nachbau bremsen will, müsste den Zugang beschränken. Der Zugang aber ist das Produkt.
Und für Europa gilt die Ausgangsfrage in umgekehrter Richtung. Abschöpfen löst ein Problem, das Europa gar nicht hat. Die Probleme, die es tatsächlich hat, löst es nicht.
Wer vorne mitspielen will, muss die Runde selbst bezahlen, die er gewinnen möchte.
Quellen
- Epoch AI: Open vs. closed AI. How behind are open models? Laufende Datenreihe, abgerufen am 31.07.2026. https://epoch.ai/data-insights/open-closed-eci-gap
- Europäische Kommission: Guidelines on the scope of the obligations for providers of general-purpose AI models under the AI Act, 18.07.2025. Die Aussagen zum Rechenaufwand stützen sich auf die Randnummern 17, 60, 61, 117 und 119 des englischen Originalwortlauts. https://digital-strategy.ec.europa.eu/en/library/guidelines-scope-obligations-providers-general-purpose-ai-models-under-ai-act
- Europäische Kommission: Explanatory Notice and Template for the Public Summary of Training Content for general-purpose AI models, 24.07.2025, zu Art. 53 Abs. 1 lit. d AI Act. Die Auslegung zur Benennung der Quellmodelle stammt aus der Analyse von WilmerHale vom 13.08.2025, nicht aus dem Wortlaut der Vorlage. https://www.wilmerhale.com/en/insights/blogs/wilmerhale-privacy-and-cybersecurity-law/european-commission-releases-mandatory-template-for-public-disclosure-of-ai-training-data
- Epoch AI: AI supercomputers performance share by country. Datenstand Mai 2025, veröffentlicht am 05.06.2025. Der Datensatz erfasst nach eigener Angabe nur 10 bis 20 Prozent der weltweiten Kapazität und für China deutlich weniger. https://epoch.ai/data-insights/ai-supercomputers-performance-share-by-country
- Epoch AI: Introducing the AI Chip Owners Explorer, 06.04.2026. Zuordnung nach Eigentümer statt Standort, einschließlich Huawei-Ascend. Quelle der Angaben von gut fünf Prozent für chinesische Unternehmen und 71 Prozent für fünf US-Anbieter. Geschmuggelte Chips und im Ausland gemietete Rechenzeit sind nicht erfasst. https://epoch.ai/blog/introducing-the-ai-chip-owners-explorer
- OECD: Venture capital investments in artificial intelligence through 2025. Policy Brief vom 17.02.2026, Datenbasis Preqin über OECD.AI. Der Bericht weist selbst darauf hin, dass er ausschließlich Wagniskapital erfasst und keine Rückschlüsse auf andere Investitionsformen erlaubt. https://www.oecd.org/content/dam/oecd/en/publications/reports/2026/02/venture-capital-investments-in-artificial-intelligence-through-2025_3bcb227f/a13752f5-en.pdf
- Stanford HAI: AI Index Report 2026. Quelle der Anteile an KI-Publikationen (China 23,2 Prozent, USA 12,6) und an den weltweiten KI-Patentanmeldungen (China 69,7 Prozent). Der Bericht hält zugleich fest, dass die wirkungsstärkeren Patente in den USA gehalten werden. https://hai.stanford.edu/ai-index/2026-ai-index-report
- MacroPolo: Global AI Talent Tracker 3.0, Auswertung von 4.622 Autoren der Konferenzen NeurIPS 2024, ICML 2024 und ICLR 2025. Quelle der Angaben zu Ausbildungs- und Arbeitsort der Spitzenforscher. https://archivemacropolo.org/interactive/digital-projects/the-global-ai-talent-tracker
- ATOM Report, Preprint arXiv:2604.07190, Stand März 2026. Quelle des Vergleichs der Hugging-Face-Abrufe (1,15 Milliarden für chinesische gegenüber 723 Millionen für amerikanische Modelle), des Anteils von 70 Prozent an neuen Ableitungen und des über OpenRouter abgerufenen Token-Anteils. https://arxiv.org/html/2604.07190
- Stanford HAI: AI Index Report 2026, Kapitel Economy. Quelle der privaten Gesamtinvestition (USA 285,9 gegenüber China 12,4 Milliarden Dollar) und der Schätzung von rund 184 Milliarden Dollar aus staatlichen Leitfonds. https://hai.stanford.edu/ai-index/2026-ai-index-report/economy
- Bertin Martens: Catch up with the US or prosper below the tech frontier? An EU artificial intelligence strategy. Bruegel Policy Brief 25/2024, 21.10.2024. Quelle der Budgetvergleiche zu EuroHPC. https://www.bruegel.org/policy-brief/catch-us-or-prosper-below-tech-frontier-eu-artificial-intelligence-strategy
- Maria Nowicka: From Chips to Grids. Why Energy Constraints Influence AI Compute Expansion in Europe. interface, 05.05.2026. https://www.interface-eu.org/publications/ai-compute-energy-bottlenecks
- OpenEuroLLM: First year progress and next steps, 06.03.2026. Budget- und Zeitangaben nach Projektangabe. https://openeurollm.eu/blog/first-year-progress-and-next-steps
- Europäische Kommission: AI Gigafactories. Zeitleiste von der Ankündigung im Februar 2025 bis zum geplanten Baubeginn 2027. https://commission.europa.eu/topics/competitiveness/competitiveness-coordination-tool-projects/ai-gigafactories_en
- Fraunhofer IAIS: Teuken-7B. Pressemitteilung vom 26.11.2024. https://www.iais.fraunhofer.de/en/press-events/press-releases/press-release-241126.html
- Aleph Alpha: Introducing Pharia-1-LLM. Herstellerangabe vom 26.08.2024. https://aleph-alpha.com/en/blog/introducing-pharia-1-llm-transparent-and-compliant/
- Mark A. Lemley, zitiert von der Stanford Law School, 31.01.2025, zur Durchsetzbarkeit von Nutzungsbedingungen gegen Distillation nach US-Recht. https://law.stanford.edu/press/openai-has-little-legal-recourse-against-deepseek-tech-law-experts-say/
- AMD: Übernahme von Silo AI, Mitteilung vom 10.07.2024. Sowie CNBC und TechCrunch vom 24. und 25.04.2026 zum Zusammenschluss von Cohere und Aleph Alpha. https://www.amd.com/en/newsroom/press-releases/2024-7-10-amd-to-acquire-silo-ai-to-expand-enterprise-ai-sol.html
- Black Forest Labs: Series-B-Finanzierung, Dezember 2025, sowie die Vorstellung von FLUX 3 im Juli 2026. Angaben aus Unternehmensmitteilung und Fachberichterstattung. https://venturebeat.com/technology/black-forest-labs-launches-flux-3-capable-of-generating-images-and-20-second-video-with-audio-but-in-limited-release-to-start
- Artificial Analysis: Intelligence Index, Leaderboards abgerufen am 31.07.2026. Die Angabe zur Parameterzahl von Mistral Large 3 stammt aus einer Sekundärquelle und wurde nicht am Herstellerdokument geprüft. https://artificialanalysis.ai/leaderboards/models
- Luke Emberson: US vs. China. How far behind are Chinese AI models? Epoch AI, 02.01.2026. Quelle der Angabe von sieben Monaten. https://epoch.ai/data-insights/us-vs-china-eci
- Peter Henderson, Mark Lemley u. a.: Preprint zu Nutzungsbedingungen und ihrer Durchsetzung, arXiv:2412.07066, Dezember 2024. Quelle der Feststellung, dass kein Modellanbieter diese Klauseln je durchgesetzt hat. https://arxiv.org/abs/2412.07066
- Anthropic: Project Glasswing und Claude Mythos Preview, Programmstart 07.04.2026, Erweiterung auf rund 150 Organisationen am 02.06.2026. Quelle der Angaben zum Vorab-Zugang. https://www.anthropic.com/news/claude-fable-5-mythos-5
- Anthropic: Brief an den Bankenausschuss des US-Senats vom 10.06.2026, unterzeichnet von Sarah Heck. Die dort genannten 28,8 Millionen Austausche werden Akteuren aus dem Umfeld von Alibaba zugeordnet, nicht Moonshot. Quelle der Angaben zu 28,8 Millionen Austauschen und knapp 25.000 Konten sowie der Einordnung als Verstoß gegen die Nutzungsbedingungen. Sowie Anthropics Veröffentlichung vom 23.02.2026 zu Zugriffsmustern chinesischer Labore. Der Brief selbst ist nicht als Primärdokument abrufbar, die Angaben folgen der Berichterstattung darüber.
- OpenAI: Eingabe an das House Select Committee on the Chinese Communist Party vom 12.02.2026. Quelle der Formulierung, die Beobachtungen seien mit Distillation vereinbar. Das Dokument ist nicht öffentlich abrufbar, die Angaben stützen sich auf die Berichterstattung darüber.
- Offener Brief „Open Weights and American AI Leadership” vom 24.07.2026, mitgezeichnet unter anderem von OpenAI und Google. Quelle der Bezeichnung von Distillation als weit verbreitetes Verfahren. Keine dauerhafte Fundstelle verfügbar, Wiedergabe nach der Berichterstattung.
- Zum Urheberrecht: Thaler v. Perlmutter, D.C. Circuit, Urteil vom 18.03.2025, Nichtannahme der Revision durch den Supreme Court am 02.03.2026, zur Voraussetzung menschlicher Urheberschaft. Sowie EuGH, Rs. C-203/02 (British Horseracing Board, 09.11.2004) zur Abgrenzung von Erzeugung und Beschaffung im Datenbankrecht und Rs. C-30/14 (Ryanair, 15.01.2015) zur vertraglichen Beschränkbarkeit ungeschützter Daten. Für die EU fehlt eine Entscheidung zur Schutzfähigkeit von Modellausgaben; die Einordnung folgt der vorherrschenden Auffassung, unter anderem einer Studie des Europäischen Parlaments vom Juli 2025. https://www.europarl.europa.eu/RegData/etudes/STUD/2025/774095/IUST_STU(2025)774095_EN.pdf
- Richtlinie (EU) 2016/943 über den Schutz von Geschäftsgeheimnissen, Art. 3 Abs. 1 lit. b und Art. 4 Abs. 3 lit. c. https://eur-lex.europa.eu/eli/dir/2016/943/oj/eng Im Vergleich dazu 18 U.S.C. § 1839(6), der Reverse Engineering vom Begriff der unlauteren Mittel ausnimmt. Zur Durchsetzbarkeit vertraglicher Verbote nach US-Recht: Bowers v. Baystate Technologies, 320 F.3d 1317 (Fed. Cir. 2003), Entscheidung vom 29.01.2003, ergangen zu einer Shrinkwrap-Lizenz und mit Sondervotum zur Frage der urheberrechtlichen Sperrwirkung. https://law.justia.com/cases/federal/appellate-courts/F3/320/1317/615628/ Die deutsche Umsetzung im Geschäftsgeheimnisgesetz wurde nicht geprüft.
- DeepSeek-AI: DeepSeek-V2 (Multi-head Latent Attention), arXiv:2405.04434, sowie DeepSeekMath (GRPO), arXiv:2402.03300, sowie Native Sparse Attention, arXiv:2502.11089, ausgezeichnet als eines von vier besten Papers der ACL 2025. https://2025.aclweb.org/program/awards/
- Fabian Gloeckle u. a.: Better & Faster Large Language Models via Multi-token Prediction. Meta, arXiv:2404.19737, 2024. Beleg für die Gegenrichtung des Wissensflusses. https://arxiv.org/abs/2404.19737
- Bertin Martens: How DeepSeek has changed artificial intelligence and what it means for Europe. Bruegel Policy Brief 12/2025, 20.03.2025. https://www.bruegel.org/policy-brief/how-deepseek-has-changed-artificial-intelligence-and-what-it-means-europe
- Michael Kratsios: Beitrag auf X vom 22.07.2026 (@mkratsios47). Wortlaut des Vorwurfs gegen Moonshot. https://x.com/mkratsios47/status/2079933645888880708
- TechCrunch: Treasury threatens sanctions after White House claims Moonshot distilled Anthropic’s Fable, 22.07.2026, sowie Experts say exploiting Anthropic’s Fable isn’t how Kimi K3 got so good, 23.07.2026. Quelle für Bessents Äußerung, für das Fehlen technischer Belege und für die Einschätzungen von Braden Hancock und Nathan Lambert.
- South China Morning Post: Global AI experts push back on US distillation claims against Moonshot’s Kimi K3 model, Juli 2026.
- Moonshot AI: Technischer Bericht zu Kimi K3 und Modellkarte, Juli 2026. Quelle für Erscheinungsdatum, Parameterzahl und Lizenzbedingungen. https://github.com/MoonshotAI/Kimi-K3
- Center for Security and Emerging Technology, Georgetown: Übersetzung der Stellungnahme des chinesischen Handelsministeriums vom 27.07.2026.
- Sebastian Raschka: The Big LLM Architecture Comparison. Fachblog ohne Begutachtung, im Text als Sekundärquelle für die Zuordnung einzelner Architekturbausteine gekennzeichnet. https://magazine.sebastianraschka.com/p/the-big-llm-architecture-comparison