Antworten über dem eigenen Niveau:
Der neue Economic Index über Wert und Prüfbarkeit der KI-Arbeit
Claudes Antworten liegen im Schnitt ein Bildungsjahr über dem, was die Frage verlangt. Der Abstand schwankt dabei stark, von nahe null bei publikumsgerichteten Texten bis zu fast drei Bildungsjahren bei Bildern und Grafik. Das ist für mich die unbequemste Zahl in Anthropics neuem Economic Index, denn sie führt zu einer Frage, die der Report selbst offenlässt: Kann man ein Ergebnis noch beurteilen, das über dem eigenen Ausgangsniveau liegt? Der Report unter dem Titel „Cadences” ist der granularste der Serie. Ich lese ihn hier aus der Arbeitsperspektive. Die meisten Befunde laufen am Ende auf diese eine Frage nach der Prüfbarkeit zu.
Vorab die wichtigste methodische Neuerung und ihre Grenze. Anthropic tastet die Nutzung jetzt kontinuierlich im Stundentakt ab, klassifiziert das Ergebnis jeder Konversation als „Artifact” und verknüpft die Nutzungsdaten datenschutzwahrend mit einer Befragung von rund 9.700 Nutzern. Transkripte liest dabei nur eine andere Claude-Instanz, kein Mensch (Anthropic 2026d). Die Befragung ist nicht repräsentativ, KI-nahe Berufe sind stark überrepräsentiert. Alle Survey-Daten beschreiben also Wissensarbeiter nahe an der Technologie, nicht den Arbeitsmarkt.
Claude arbeitet im Takt der Erwerbsarbeit
Der Grundbefund verankert alles Weitere: Die Nutzung folgt dem Rhythmus der Arbeit. Werktags dominiert die Erwerbsarbeit, am Wochenende springt der Anteil rein privater Konversationen von rund 35 auf knapp 50 Prozent. Claude ist also kein Freizeitwerkzeug, das nebenbei auch beruflich genutzt wird, sondern umgekehrt.
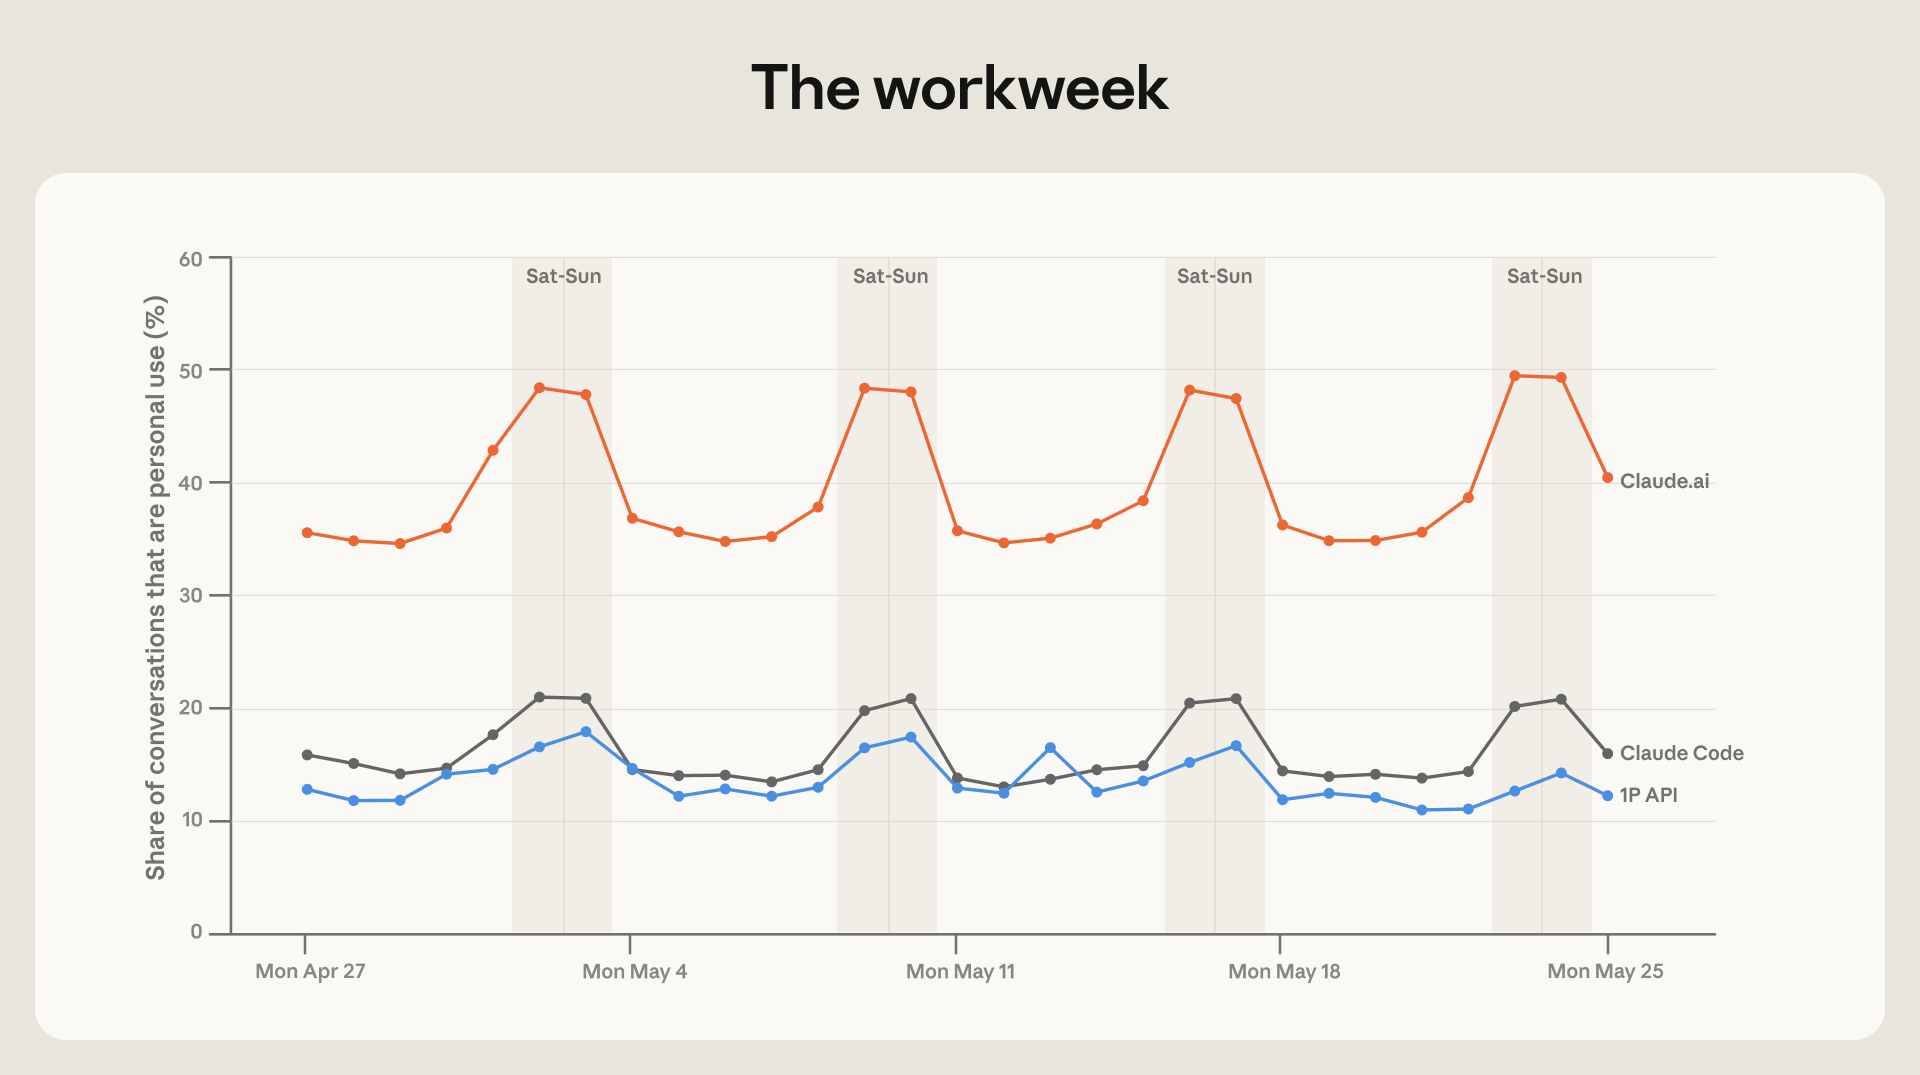
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Figure 1.1, Bildzitat).
Wer außerhalb der üblichen Zeiten mit Claude arbeitet, tut das überproportional in hochbezahlten Tätigkeiten. Nachts und am Wochenende steigt der Anteil der Aufgaben aus den beiden oberen Lohnquartilen um jeweils rund 8 Prozent, während die unteren zurückgehen. Anthropic deutet das vorsichtig, die Berufe der Nutzer lassen sich nicht direkt bestimmen. Plausibel ist, dass gerade gut bezahlte Wissensarbeit ohnehin die entgrenzten Arbeitszeiten hat, in denen dann auch die KI zum Einsatz kommt.
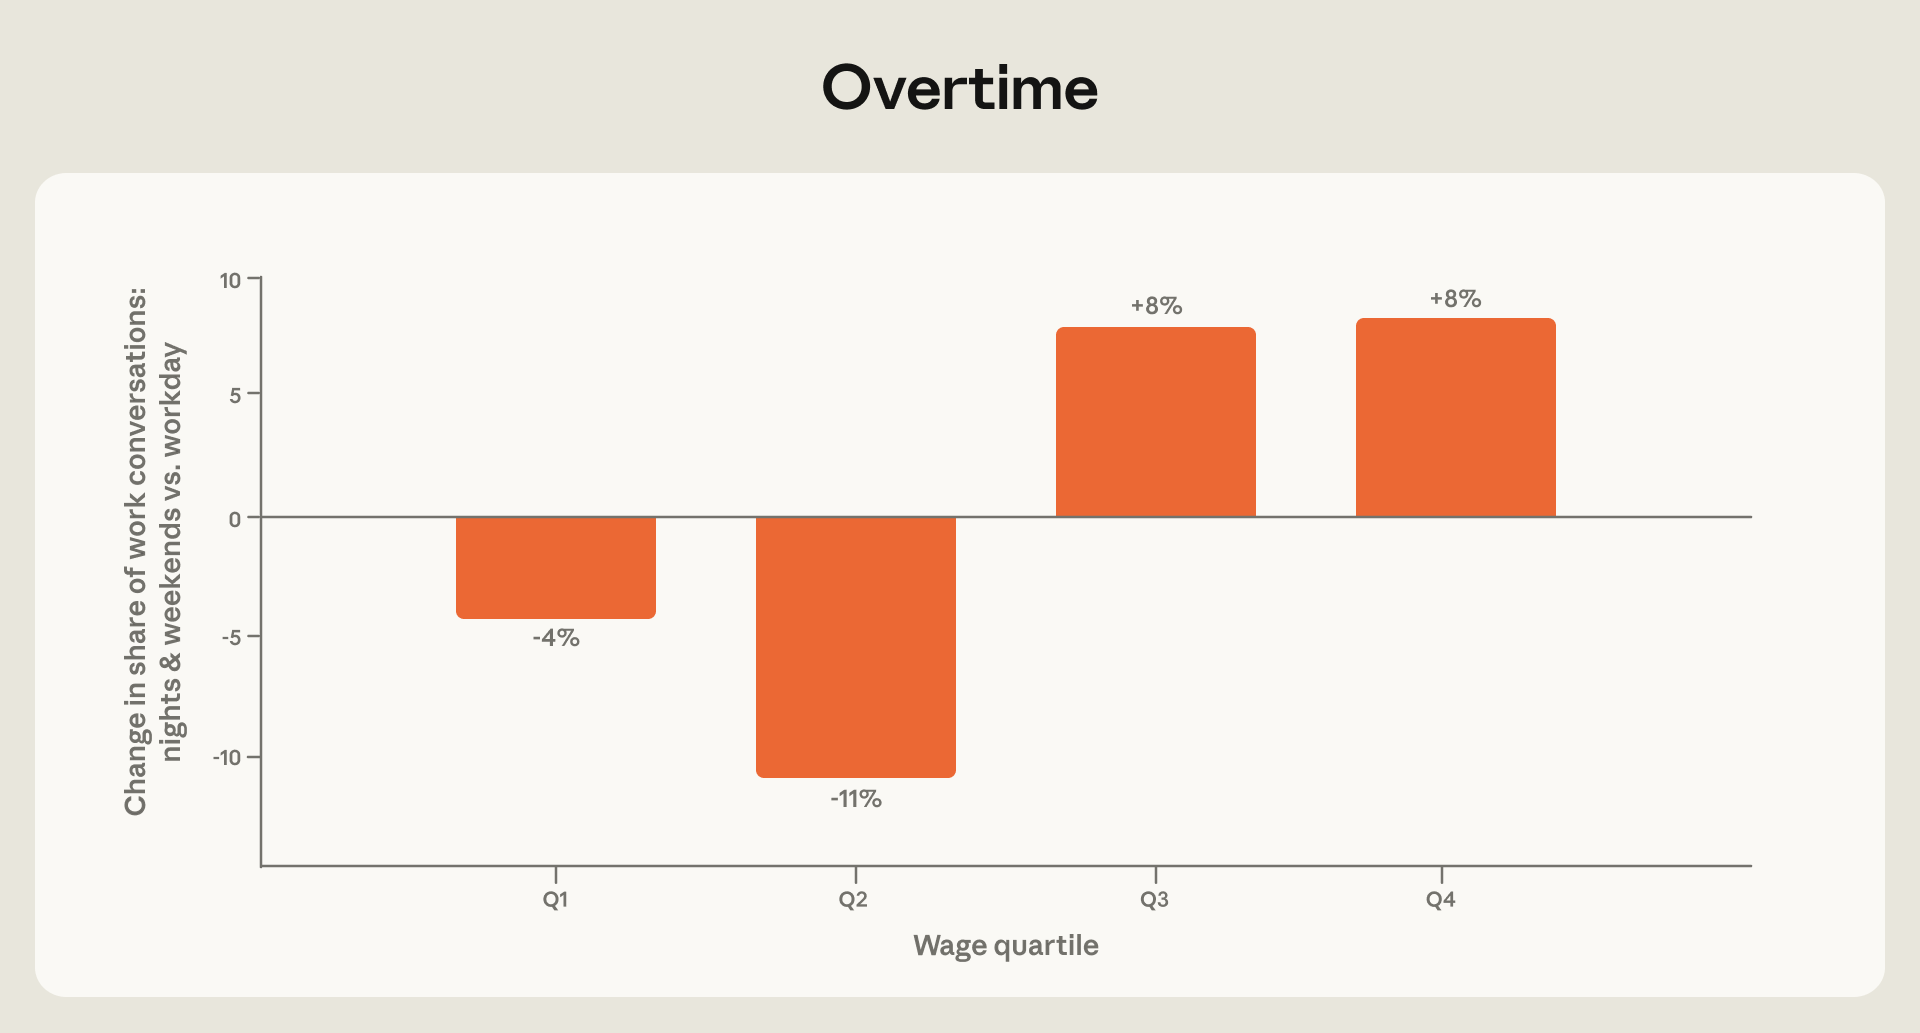
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Figure 1.3, Bildzitat).
Was dabei herauskommt und wofür
93 Prozent der Konversationen produzieren ein klassifizierbares Ergebnis, am häufigsten Erklärungen, Dokumente und Handlungsempfehlungen. Für die Arbeitsperspektive interessanter als diese Verteilung ist die Frage, welche Ergebnisse beruflich genutzt werden.
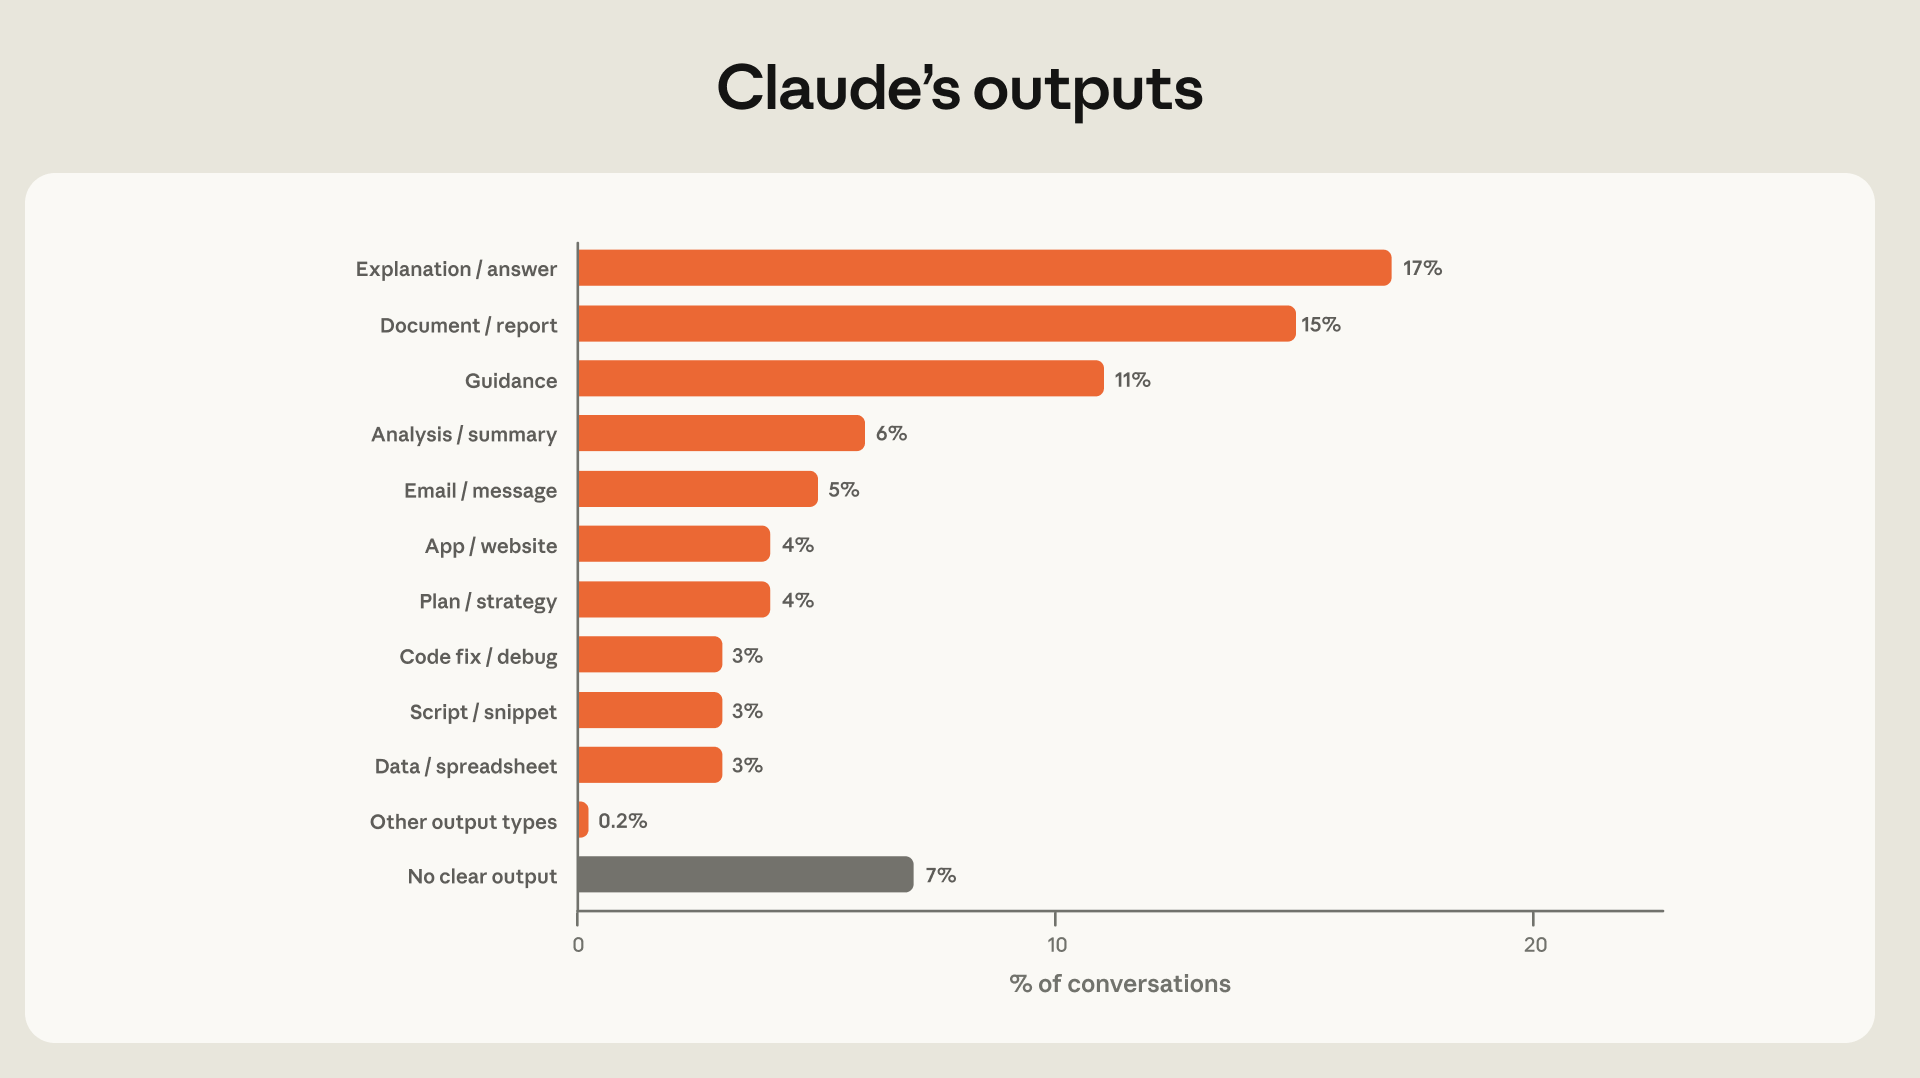
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Figure 2.1, Bildzitat).
Die Antwort trennt die Kategorien überraschend scharf. Datenbankabfragen, Blogtexte und Marketing-Inhalte sind zu über 80 Prozent beruflich, kreatives Schreiben und Rezepte zu über 80 Prozent privat. Der Ergebnistyp allein sagt also noch wenig über die berufliche Relevanz, erst der Verwendungszweck macht sie sichtbar. Wer die Wirkung von KI auf Arbeit einschätzen will, muss deshalb beides messen, nicht nur, was produziert wird, sondern auch wofür.
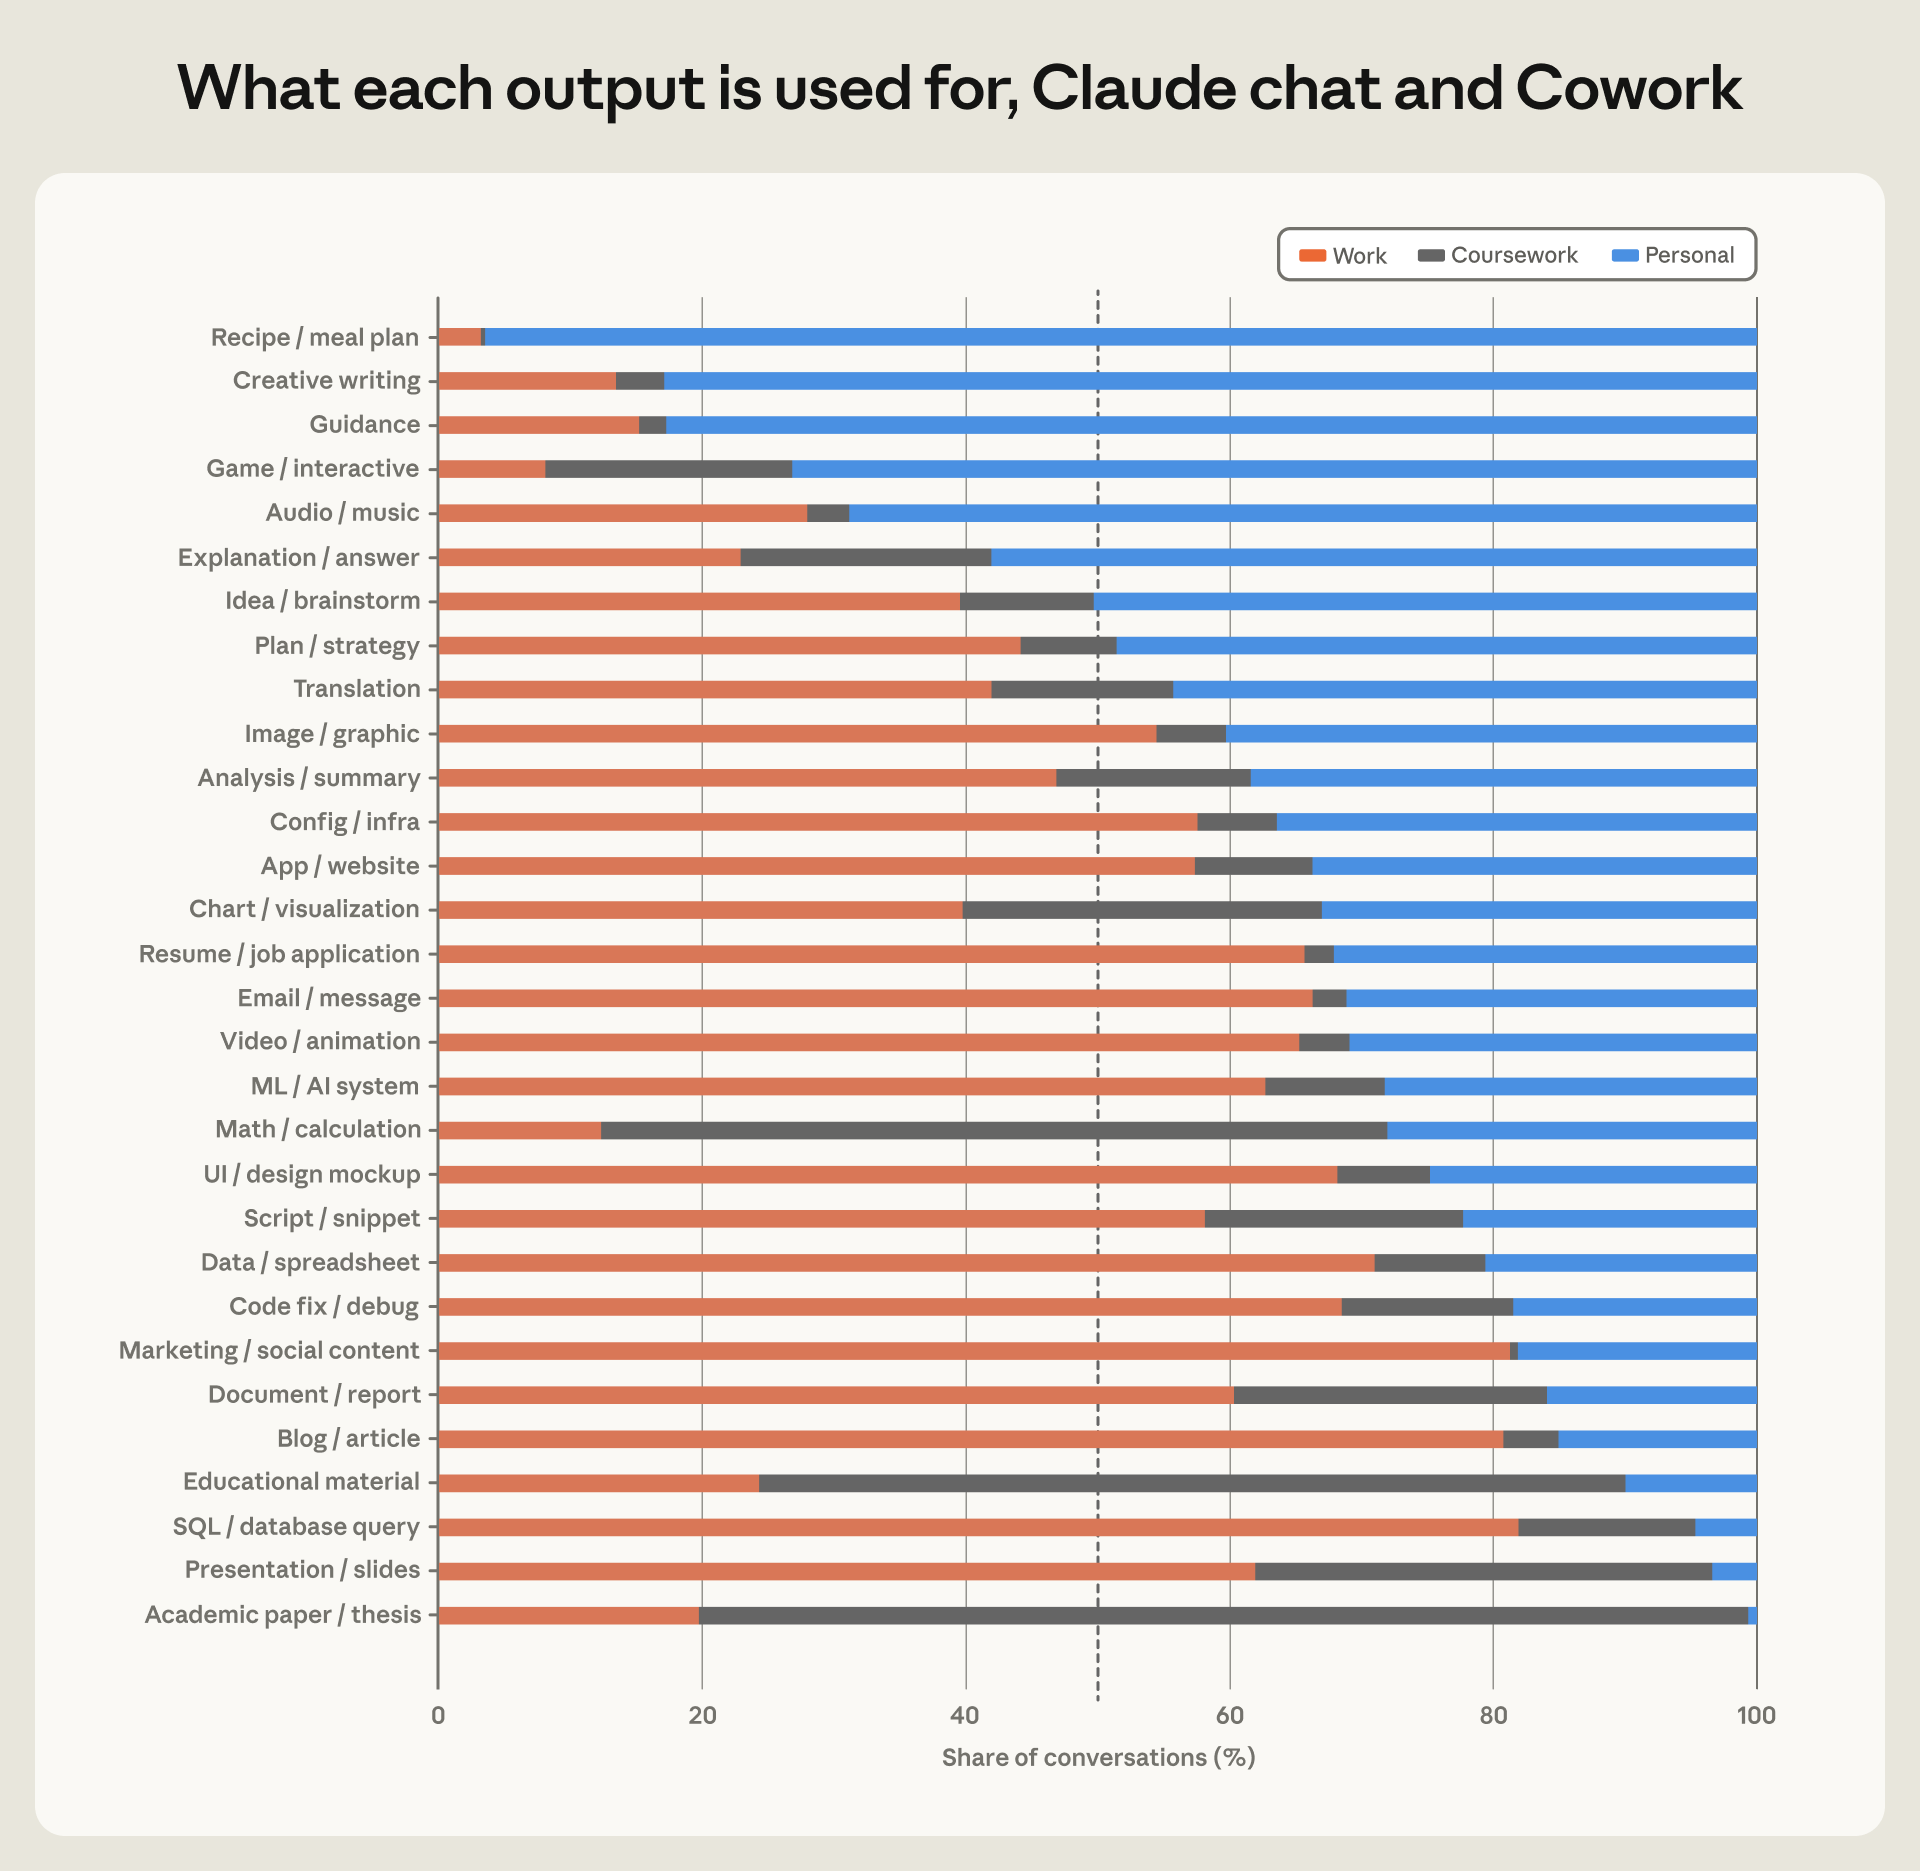
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Figure 2.2, Bildzitat).
Die Rechenkosten folgen dem Wert der Arbeit
Hier liegt der ökonomisch tragende Befund. Je höher der typische Lohn eines Berufs, desto mehr Rechenleistung verbrauchen die zugeordneten Konversationen. Marketing-Manager etwa verdienen rund doppelt so viel wie Redakteure. Ihre Aufgaben verbrauchen ungefähr das Zweieinhalbfache an Tokens. Der Zusammenhang ist verrauscht und hat Ausreißer, aber die Richtung ist eindeutig: Teurere Arbeit kostet mehr Rechenleistung, weil sie komplexere Ergebnisse verlangt.
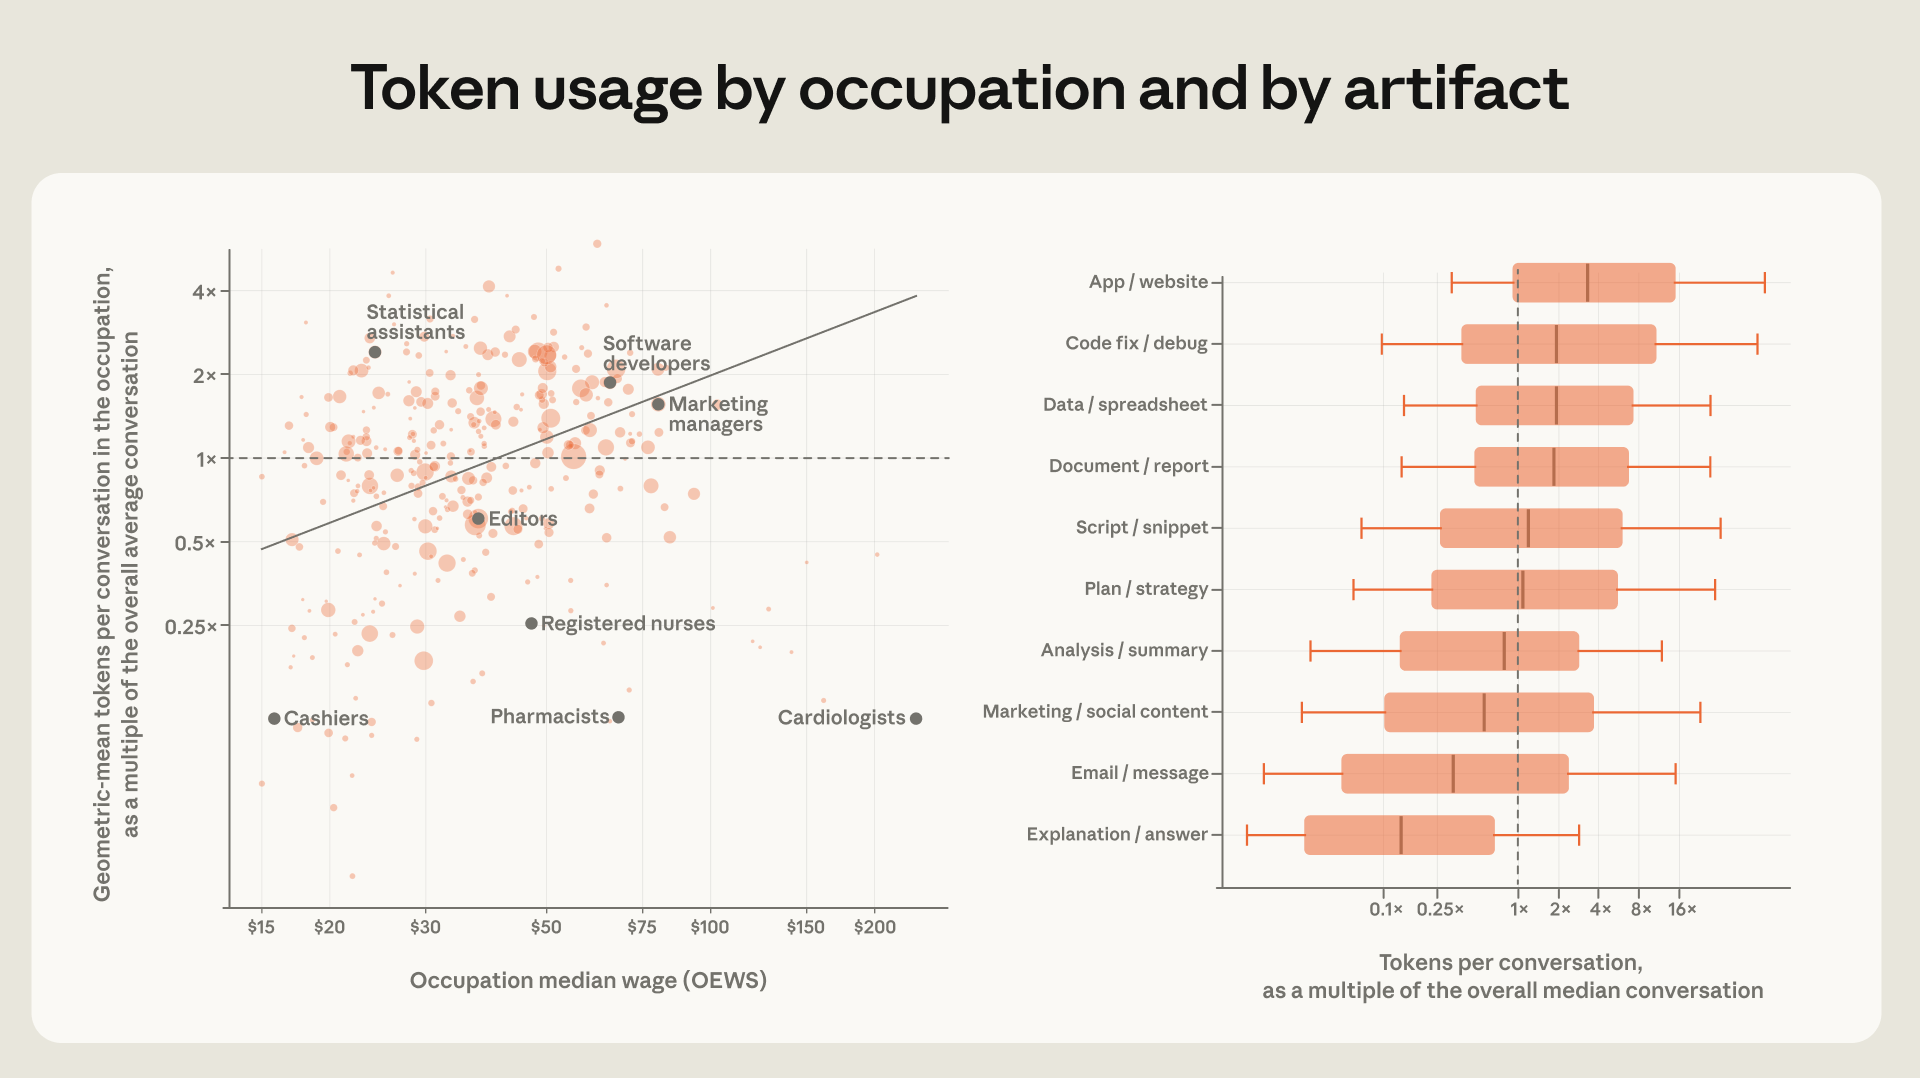
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Figure 2.3, Bildzitat).
Die entscheidende Nuance zeigt die begleitende Tabelle. Eine Konversation im obersten Lohndrittel verbraucht gut doppelt so viele Tokens wie eine im untersten. Das speist sich aber nicht nur aus mehr Maschinenleistung, sondern zugleich aus mehr menschlicher Beteiligung. Claude produziert pro Runde mehr, während die Nutzer zugleich mehr Runden schreiben. Beide Größen steigen gemeinsam. Das ist mit dem Augmentierungsbild konsistent, mehr Maschine bedeutet hier nicht weniger Mensch, sondern mehr von beidem. Ein zwingender Beweis ist es nicht, dieselbe Bewegung ließe sich zum Teil damit erklären, dass wertvollere Aufgaben schlicht länger und komplexer sind. Das ist ein stärkeres Indiz gegen die Verdrängungserzählung als jeder Appell zur Zusammenarbeit, weil es in den Rechenkosten selbst steht. Zugleich schließt es an die Ökonomie der Modellpreise an, die ich hier bereits behandelt habe (Modell-Ökonomie).
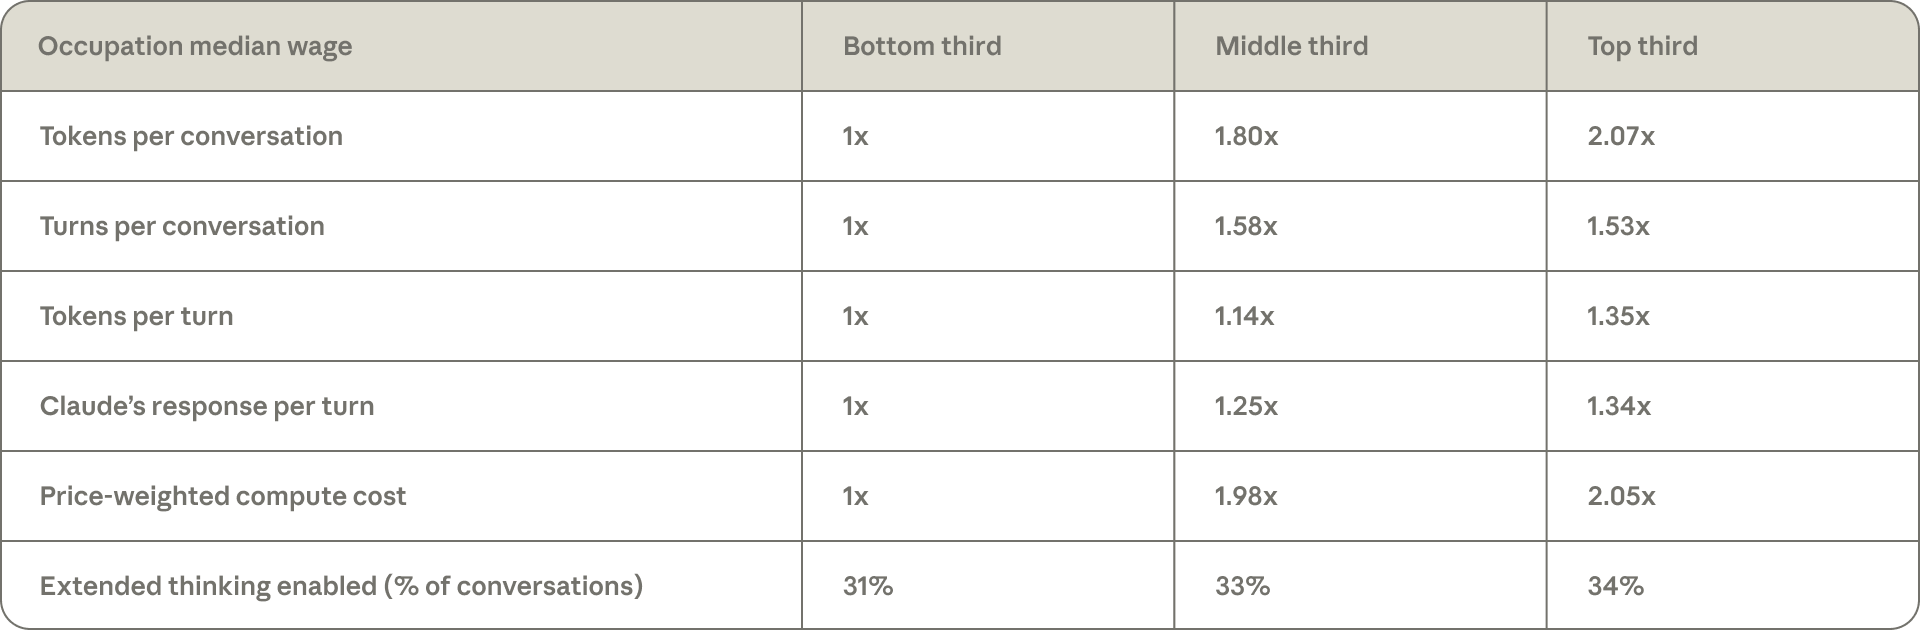
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Table 2.4, Bildzitat).
Wie viel die KI selbst entscheidet
Wie viel Entscheidungsspielraum Claude bekommt, hängt weniger vom Modell ab als vom Produkt. In Claude Code delegieren Nutzer deutlich mehr als in Chat und Cowork. Dieser Unterschied bleibt bestehen, wenn man dasselbe Modell vergleicht. Am anschaulichsten ist der Kontrast beim Blogartikel: In Chat und Cowork steckt im Median ein Dutzend Dialogrunden dahinter, in Claude Code ein einziger Prompt. Die Arbeitsumgebung entscheidet also mit darüber, wie viel ein Mensch aus der Hand gibt, oft ohne dass ihm diese Wahl bewusst ist.
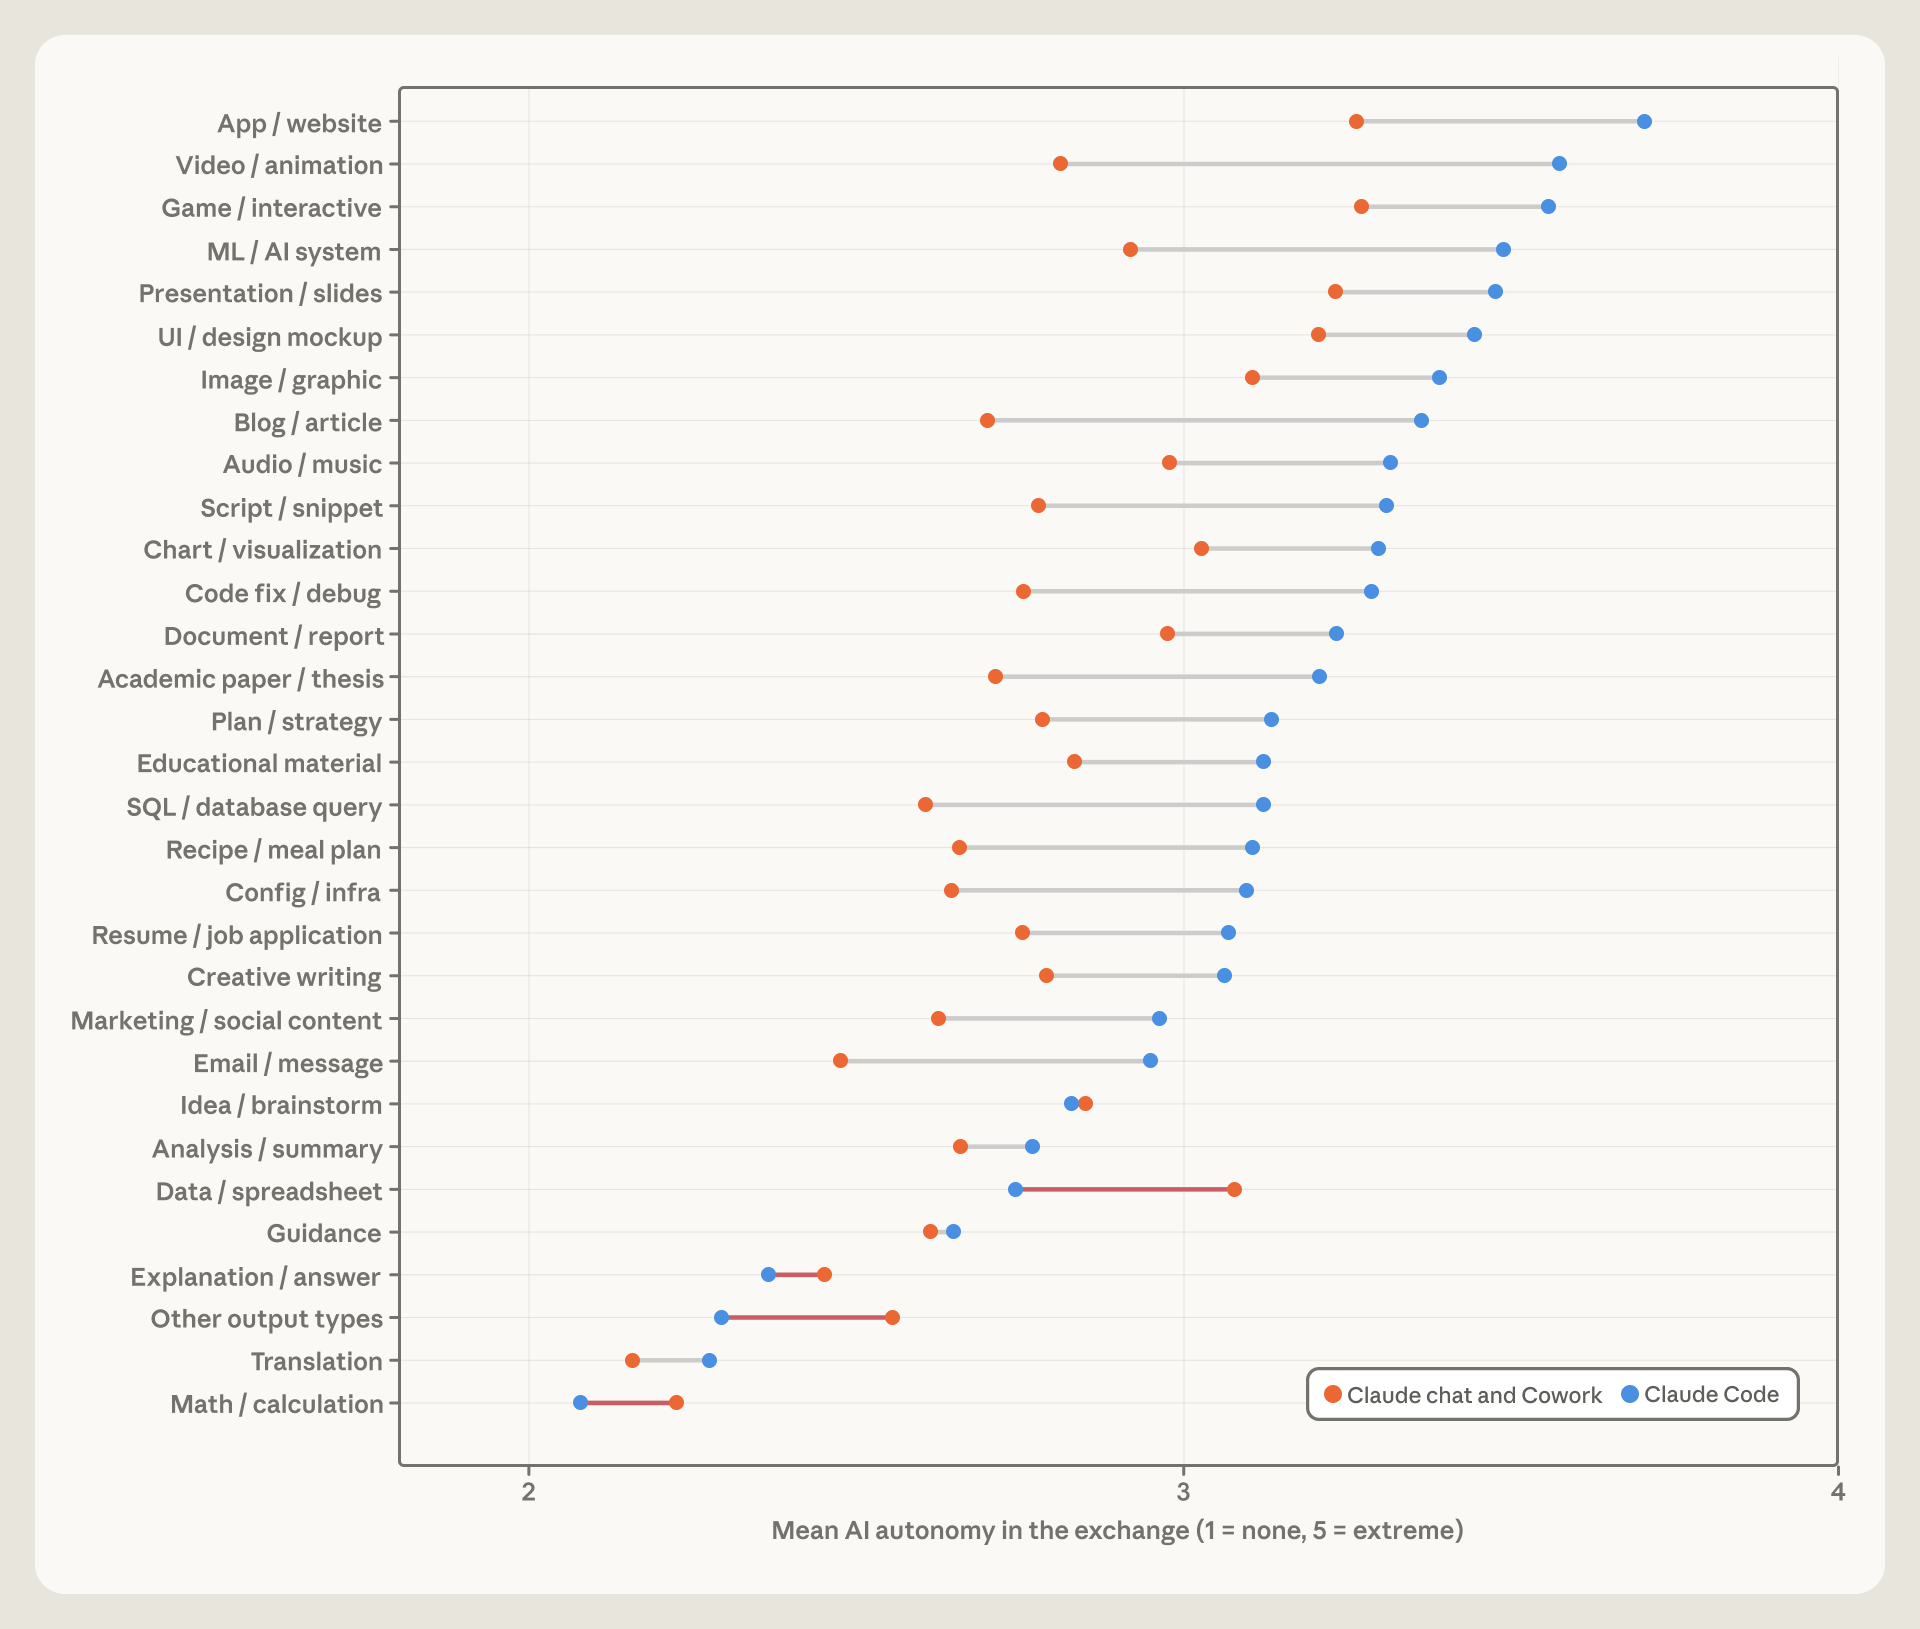
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Figure 2.5, Bildzitat).
Claude antwortet über dem Niveau der Frage
Damit zurück zum Ausgangspunkt. Anthropic schätzt für jeden Prompt und jede Antwort ein Leseniveau in Bildungsjahren. Über fast alle Ergebnistypen hinweg liegt Claudes Antwort etwa ein Bildungsjahr über dem Prompt. Am größten ist der Abstand bei Bildern, Spielen und Apps: Dort beschreiben Menschen etwas knapp, die KI arbeitet es aus. Nahe null ist er dagegen beim Schreiben für ein Publikum, wo der Prompt schon Sprache im Zielregister liefert.
Das ist zunächst produktiv, die KI hebt das Ergebnis über das an, was man selbst formuliert hätte. Eine Grenze der Kennzahl ist dabei mitzudenken: Das Leseniveau misst sprachliche Komplexität, nicht inhaltliche Korrektheit. Ein einfach formulierter Text kann falsch sein, ein komplexer richtig. Verstehen bleibt aber die Vorbedingung des Prüfens. Wenn die Antwort systematisch über dem Anforderungsniveau der Frage liegt, wächst die Last, sie zu beurteilen. Das ist mein Schluss aus der Zahl, kein gemessener Befund des Reports: Die knappe Fähigkeit wird dann nicht mehr das Formulieren, sondern das Beurteilen dessen, was zurückkommt.
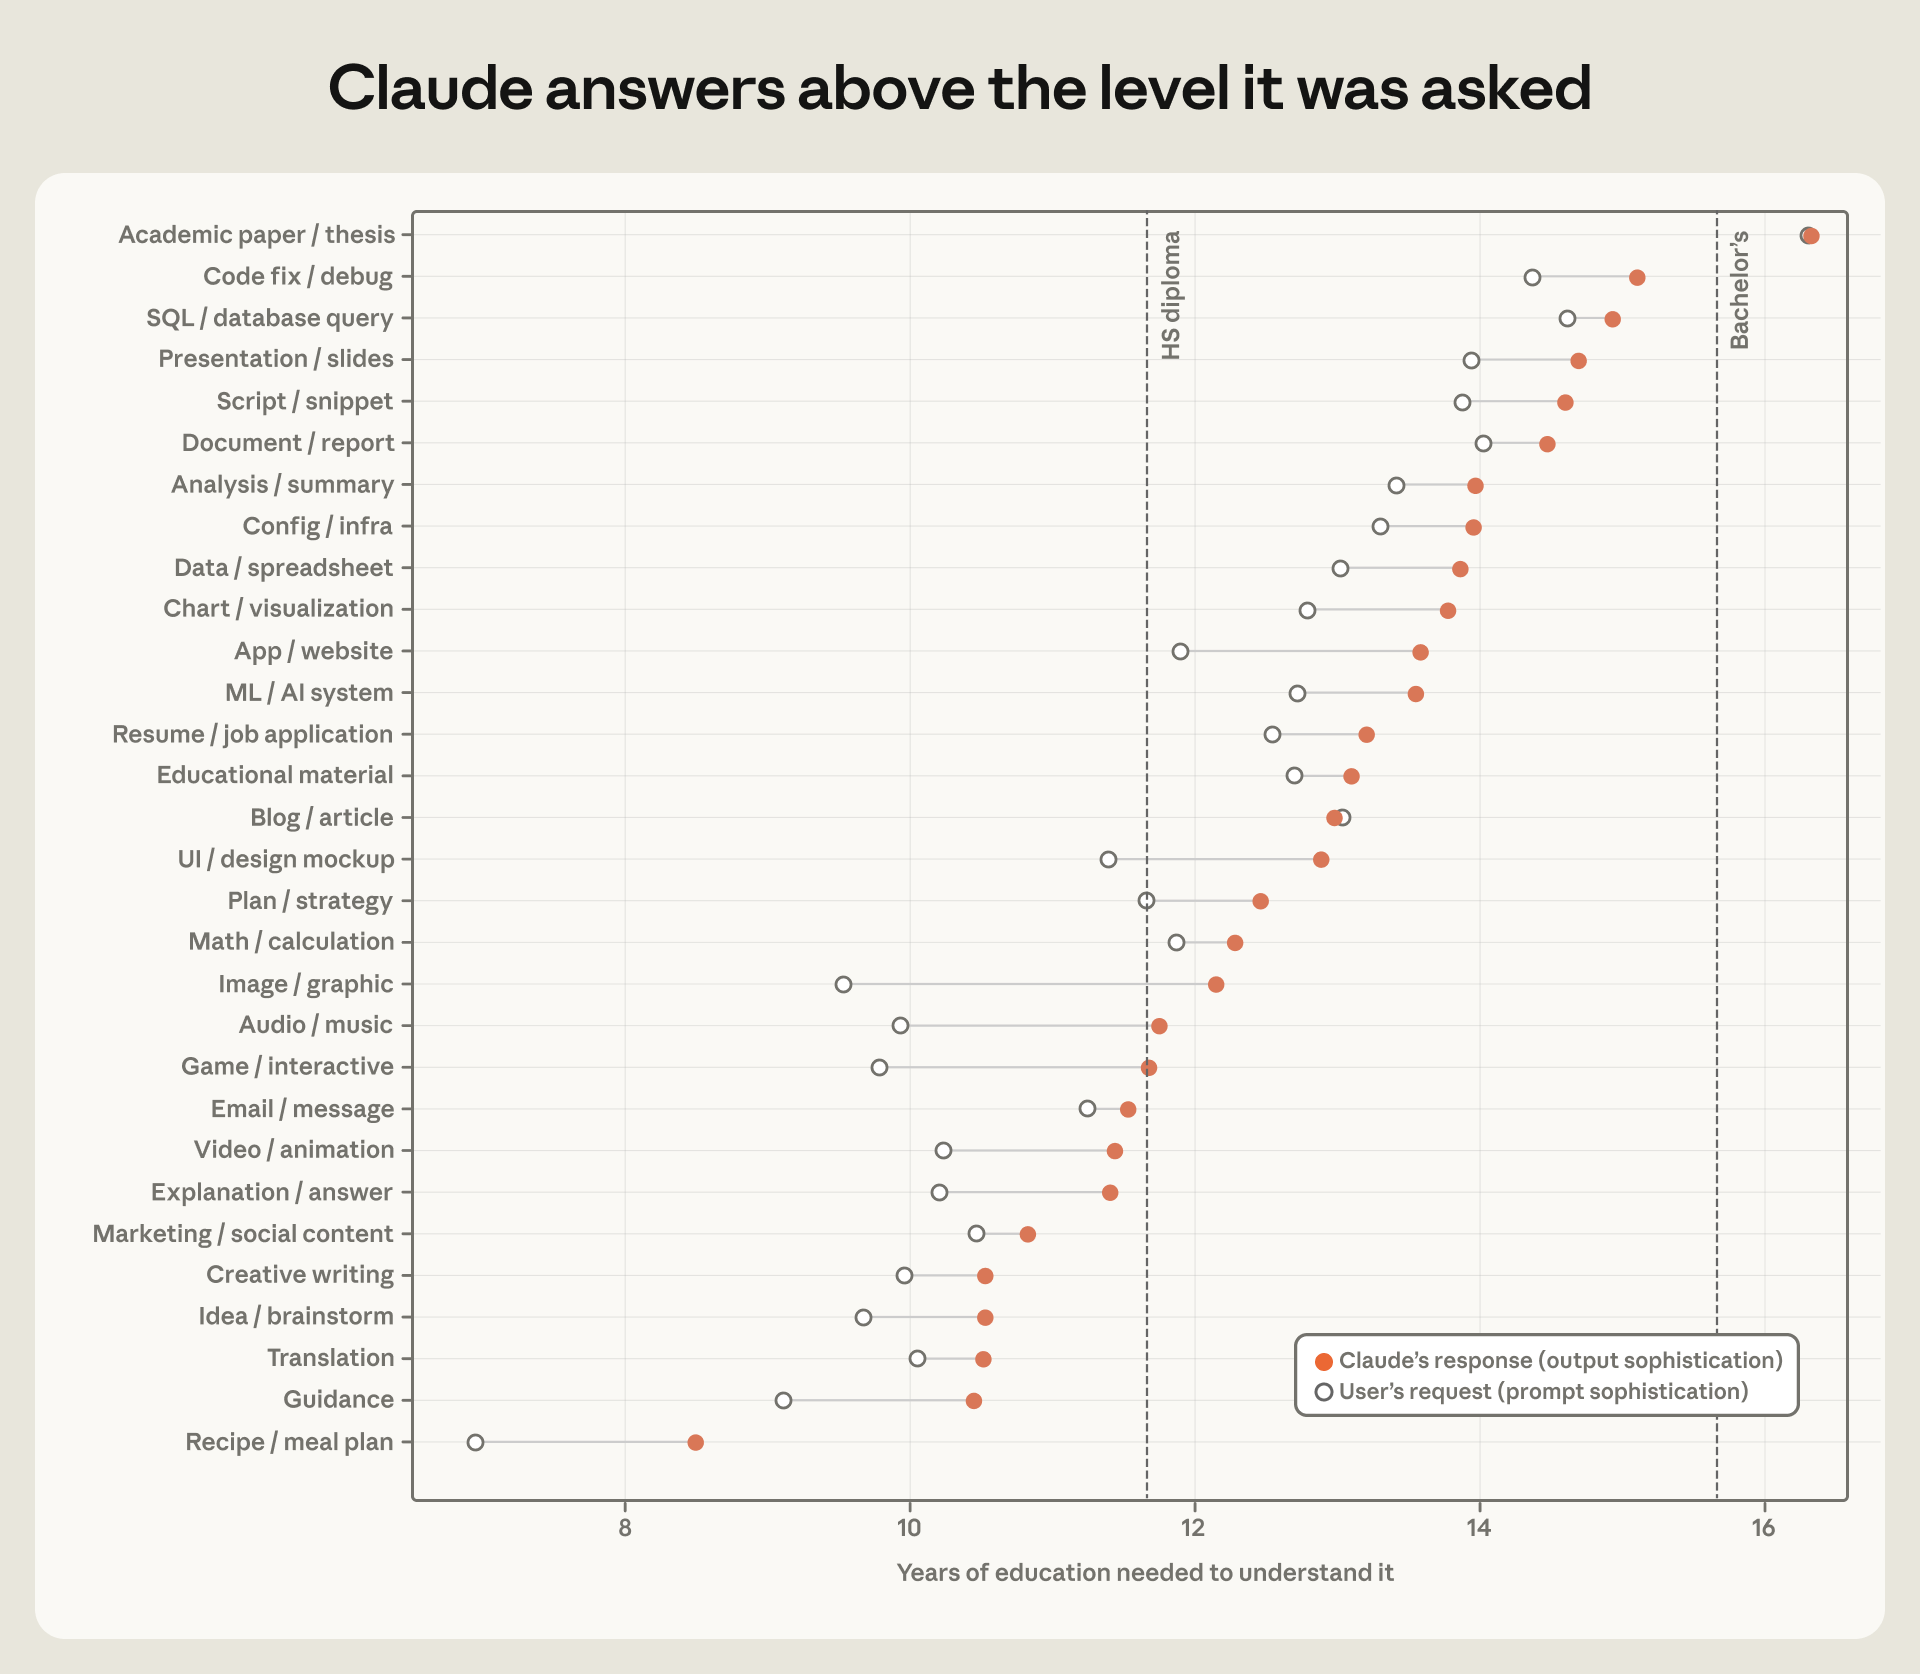
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Figure 2.6, Bildzitat).
Was die Nutzer erwarten
Die Befragung stützt diese Verschiebung von der anderen Seite. Fast 6 von 10 Befragten erwarten, dass KI in einem Jahr einen größeren Teil ihrer Arbeit allein erledigen kann als heute, über ein Drittel erwartet, dass es die meisten Aufgaben sind. Der Fortschritt gilt als gesetzt.
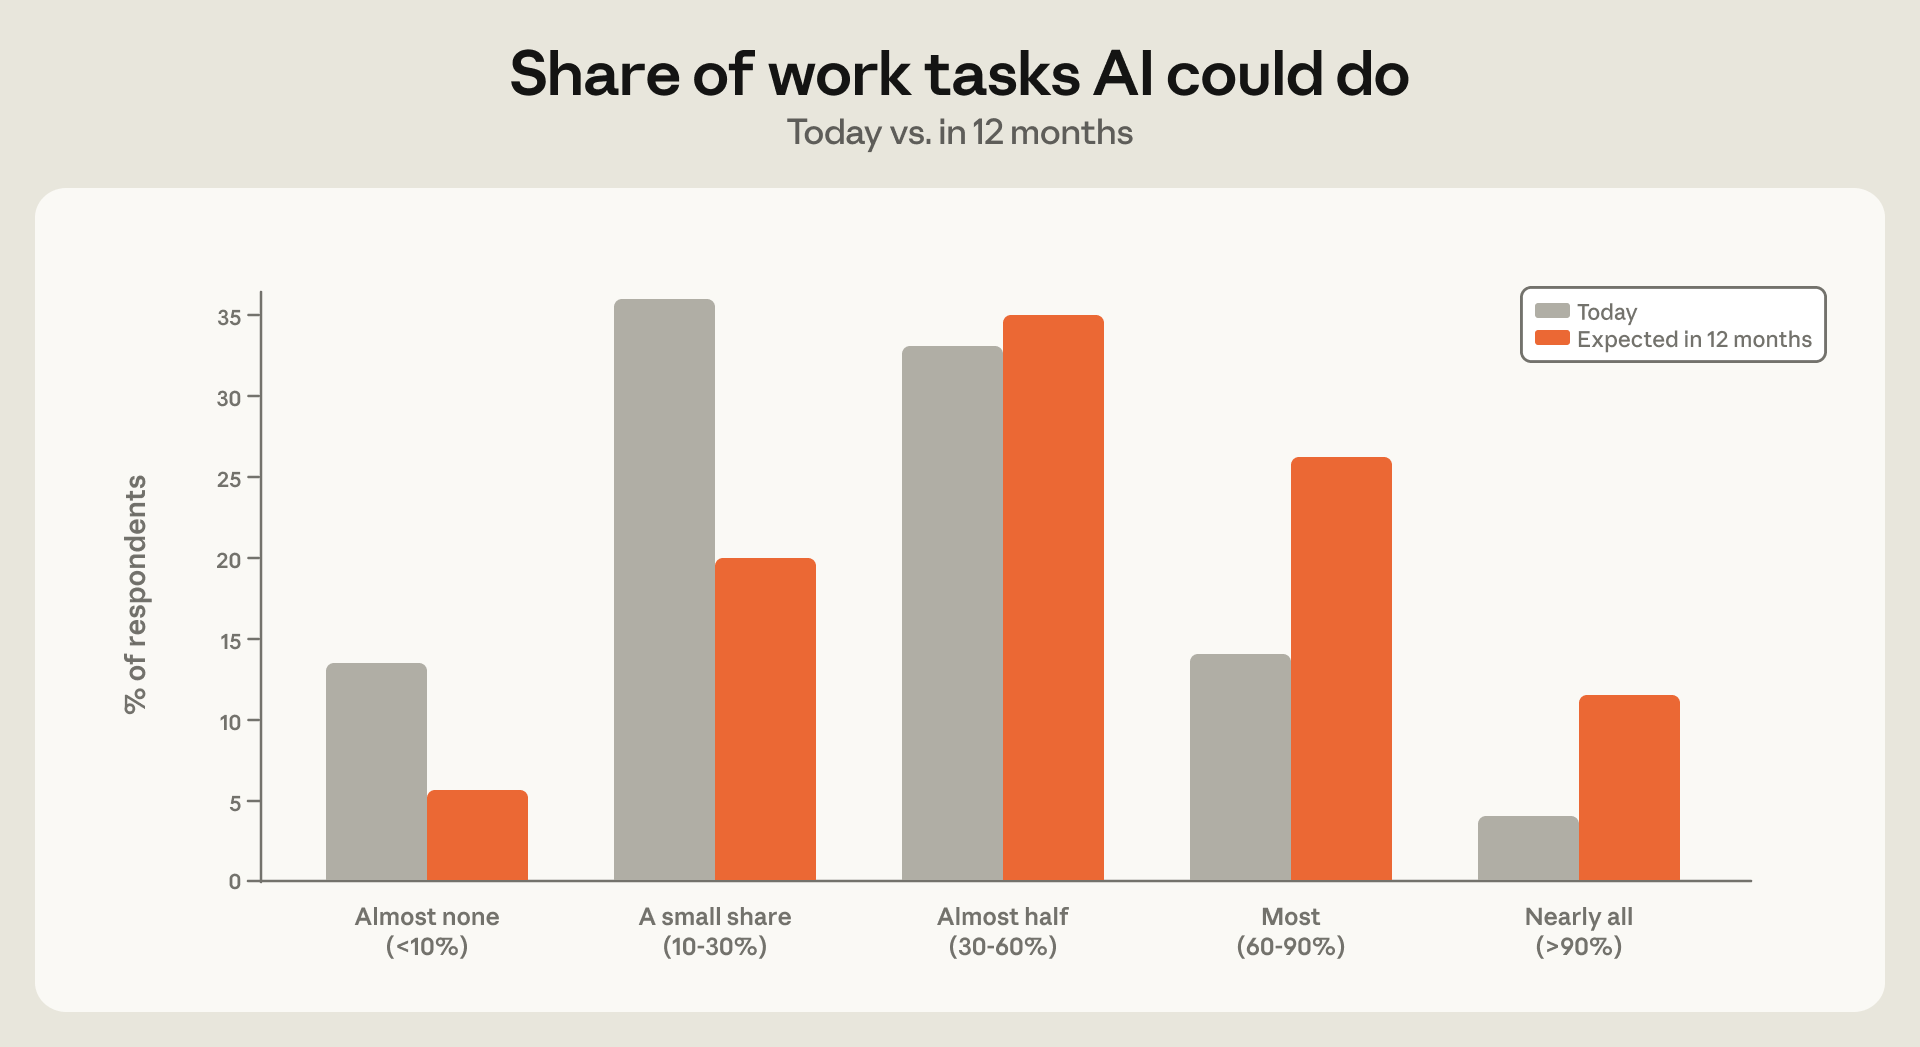
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Figure 3.2, Bildzitat).
Aufschlussreich ist, wie Menschen den Effekt auf sich selbst einschätzen. Je mehr jemand automatisiert, desto häufiger hält er die eigenen Fähigkeiten für wertvoller. Der Anteil derer, die angeben, mehr zu lernen, bleibt dagegen konstant, unabhängig vom Automatisierungsgrad. Die verbreitete Sorge, wer ganze Aufgaben abgibt, verlerne das Handwerk, findet in diesen Selbstauskünften keine Bestätigung. Was aufwertet, ist offenbar nicht das tiefere Können, sondern etwas anderes. Anthropic mahnt selbst zur Vorsicht. Es handelt sich um Selbsteinschätzungen. Kompetenz kann erodieren, während jemand sie für wertvoller hält.
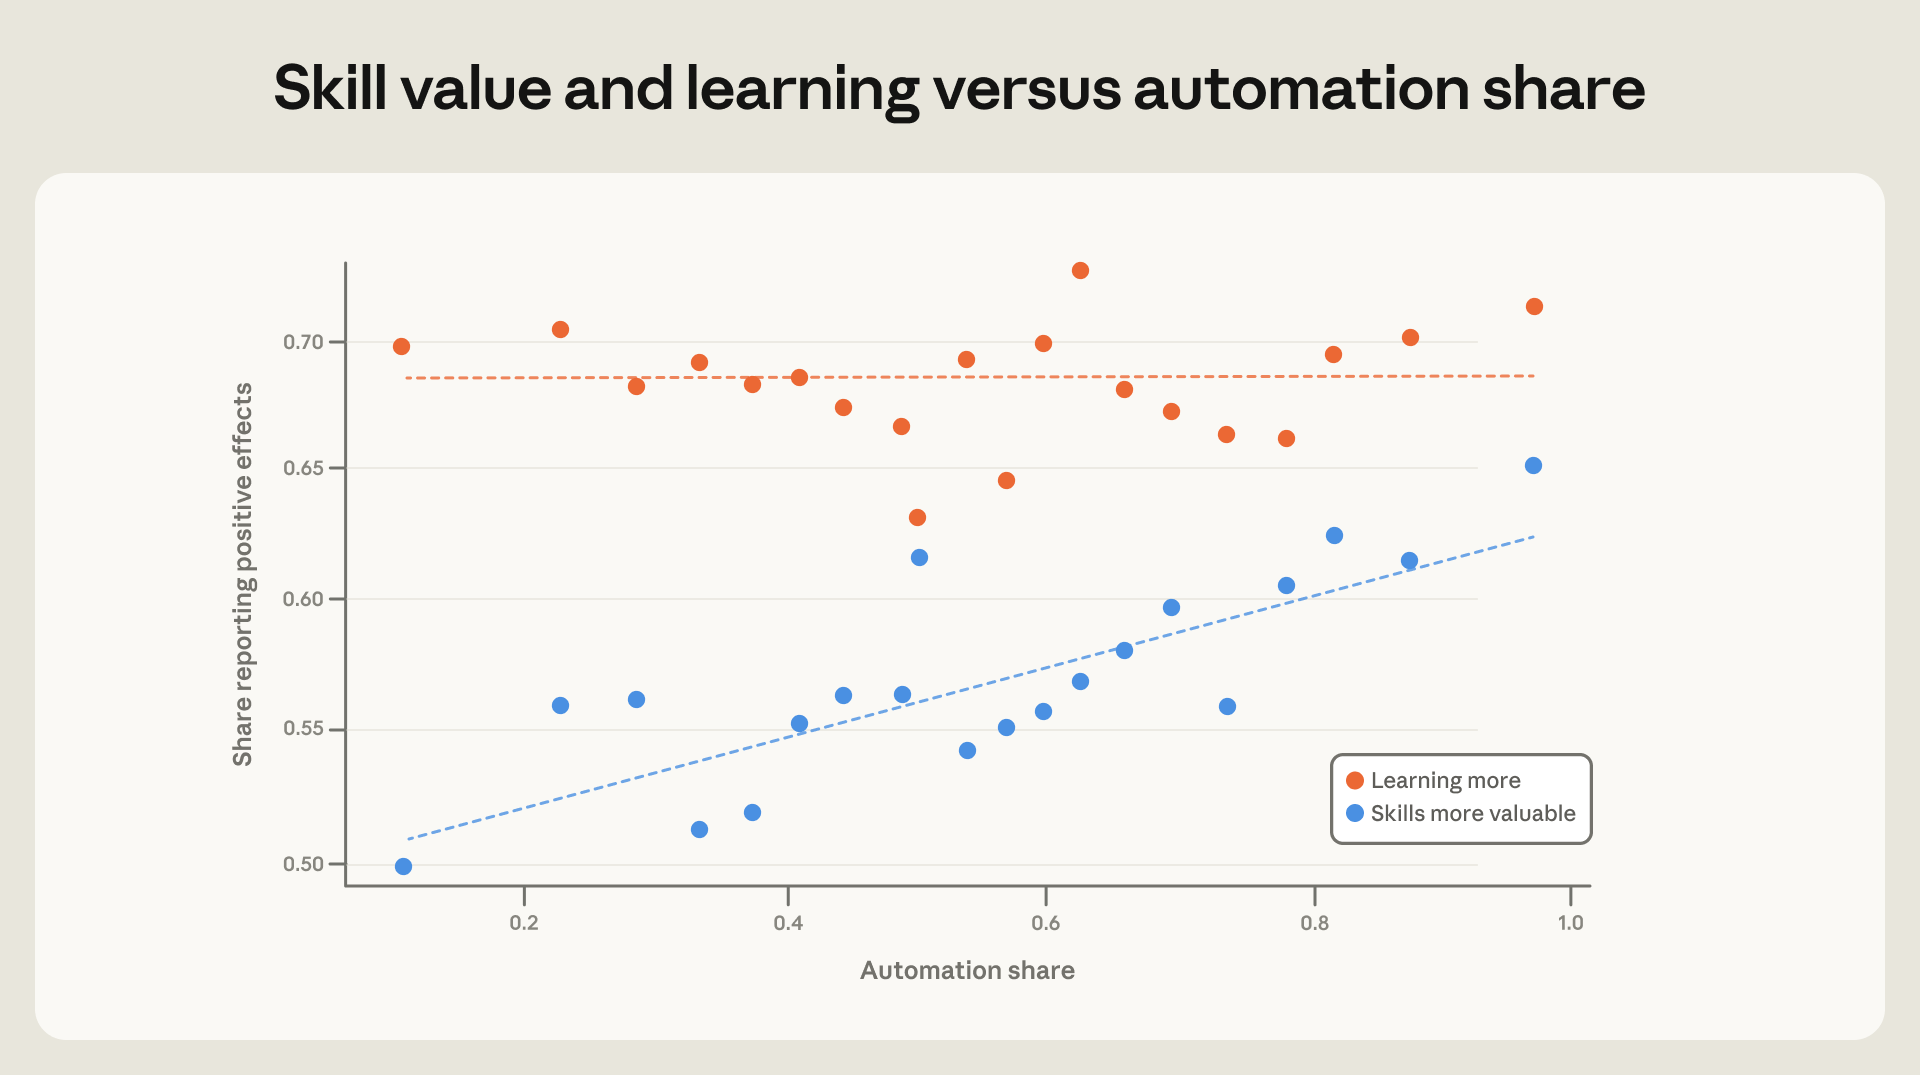
Grafik: Anthropic Economic Index Report „Cadences”, Juni 2026 (Figure 3.7, Bildzitat).
Meine Einordnung
Zusammengelesen ergeben diese Befunde ein Bild, das der Verdrängungserzählung widerspricht, ohne sie zu verharmlosen. Den Kosten-Wert-Zusammenhang deute ich als Augmentierung, mehr Maschine und mehr Mensch zugleich. Daraus folgt für die Praxis unmittelbar, dass eine pauschale Deckelung von KI-Budgets die wertvollste Arbeit zuerst trifft. Der Autonomie-Befund macht die Wahl der Arbeitsumgebung zu einer Governance-Entscheidung über Prüfprozesse, meist ohne dass sie als solche getroffen wird. Das ergänzt den Befund aus dem Cowork-Report, dass agentische Nutzung zuerst die koordinierende Zwischenarbeit übernimmt (Die Arbeit zwischen den Rollen).
Für mich läuft aber alles beim Leseniveau zusammen. Wenn die Antwort im Schnitt ein Bildungsjahr über der Frage liegt und zugleich die gefühlt wertvollste Fähigkeit mit dem Automatisierungsgrad steigt, dann verschiebt sich die eigentliche Kompetenz vom Können zum Beurteilen. Das ist eine Chance und ein Risiko in einem. Die Aufwertung ist real, aber sie trägt nur so weit, wie jemand das höhere Niveau der Antwort noch durchdringt. Wächst der Abstand über das hinaus, was man selbst prüfen kann, verlässt man sich auf ein Ergebnis, das man nicht mehr kontrolliert. Ob das noch Kompetenz ist oder nur so aussieht, lässt sich dann von außen kaum unterscheiden. Für die Ausbildung von Berufseinsteigern ist das die harte Frage. Der Report kann sie mit Selbstauskünften nicht beantworten.
Bei alledem gilt die Rahmung von oben. Der Economic Index ist ein Anbieter-Report über das eigene Produkt, keine begutachtete Studie. Er misst Nutzung, nicht Beschäftigungswirkung. Seine Stärke liegt in der Breite der Daten und in der offenen Dokumentation seiner Grenzen.
Offene Frage
Der Report zeigt eine KI, die über dem Niveau der Frage antwortet und deren Einsatz mit dem Wert der Arbeit wächst. Solange der Mensch das Ergebnis noch beurteilen kann, ist das Augmentierung. Die Frage ist, was passiert, wenn der Abstand weiter wächst. Ein Bildungsjahr lässt sich noch überbrücken, aber die Fähigkeit, die dann zählt, ist nicht mehr das Erstellen, sondern das Prüfen. Offen bleibt, ob Organisationen und Ausbildungswege diese Prüfkompetenz gezielt aufbauen oder stillschweigend voraussetzen. Sonst rutscht irgendwann ein Fehler durch, den niemand mehr als solchen erkennt.
Quellen
- Anthropic (2026d). Anthropic Economic Index report: Cadences. anthropic.com/research. https://www.anthropic.com/research/economic-index-june-2026-report (direkt eingesehen am 17.07.2026, alle Zahlen und Grafiken daraus; Angaben zur Survey-Methodik ebenfalls aus diesem Report)
- Anthropic (2026c). How people are using Claude Cowork. https://claude.com/blog/how-people-are-using-claude-cowork (direkt eingesehen für den früheren Beitrag, als Kontext referenziert)