Das beste Modell für alles ist der teuerste Fehler:
Wie aus einer Forschungsidee ein Produkt wurde
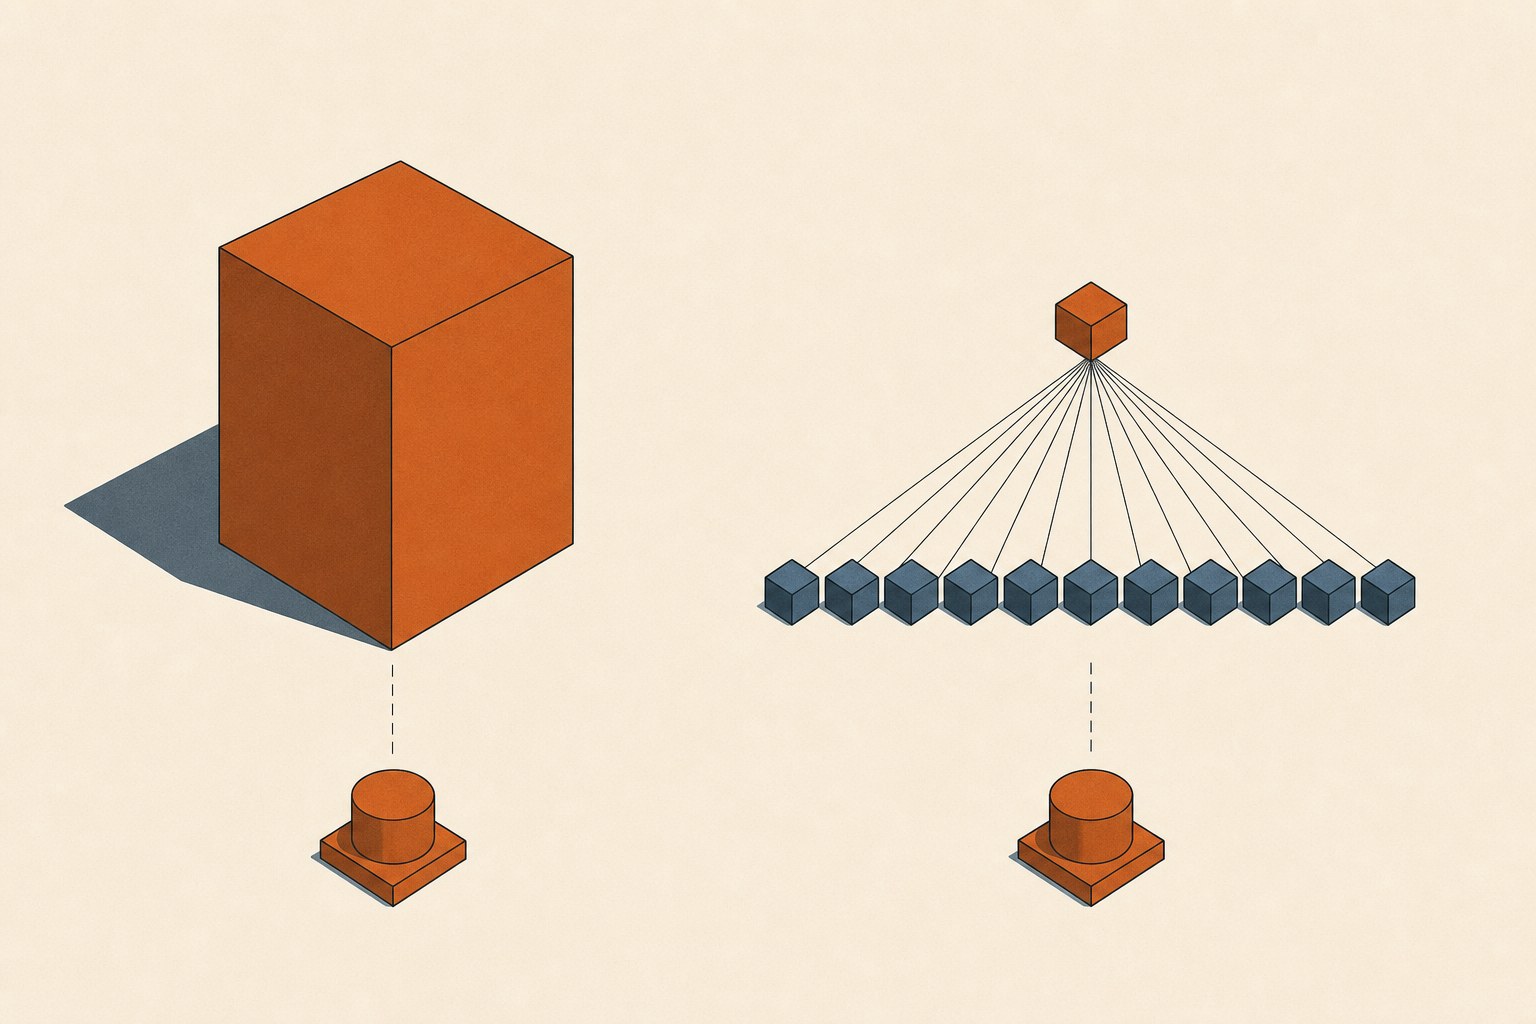
Seit drei Jahren verfolgt die Forschung eine naheliegende Idee. Nicht jede Anfrage an eine KI braucht das teuerste Modell. Wenn eine einfache Frage genauso gut von einem günstigen Modell beantwortet wird, warum sollte man dafür Spitzenpreise zahlen? Im Juli hat Cursor diese Idee erstmals mit Nutzungsdaten in großem Maßstab getestet. Das Ergebnis fällt gut aus. Interessanter ist allerdings eine zweite Zahl, die das Unternehmen vier Tage vorher veröffentlicht hat und die zeigt, dass der Modellwechsel nur der kleinere Hebel ist.
Die Idee
Im Mai 2023 veröffentlichten Lingjiao Chen, Matei Zaharia und James Zou einen Aufsatz mit dem Titel FrugalGPT. Ihr Vorschlag war simpel. Man schickt eine Anfrage zuerst an ein billiges Modell und prüft, wie sicher die Antwort wirkt. Wirkt sie unsicher, geht dieselbe Anfrage an ein teureres Modell weiter. Auf ihren Testdaten sank die Rechnung dadurch drastisch, in einem Fall um 98 Prozent bei gleicher Trefferquote.
Die Zahl klingt spektakulär und ist es auch, allerdings unter Laborbedingungen. Die drei testeten Aufgaben mit kurzen, eindeutig prüfbaren Antworten, etwa das Einordnen von Finanznachrichten. Die Preise stammten aus dem Frühjahr 2023, als zwischen dem billigsten und dem teuersten Modell ein Faktor von mehr als hundert lag. Trotzdem wurde die Arbeit 784-mal zitiert und begründete ein eigenes Forschungsfeld. Der Fachbegriff dafür ist Routing, zu Deutsch das Weiterleiten einer Anfrage an das jeweils passende Modell.
Die Ernüchterung
In den folgenden zwei Jahren wurde die Idee genauer vermessen. Und je genauer man hinsah, desto mehr Bedingungen kamen zum Vorschein.
Eine Gruppe um Dujian Ding zeigte 2024 auf der Konferenz ICLR, dass man rund 40 Prozent der Anfragen vom teuren Modell wegnehmen kann, ohne dass die Qualität leidet. Ihre eigene Ergebnistabelle enthält aber eine Einschränkung, die selten mitzitiert wird. Der Befund gilt für zwei Modelle, die ungefähr gleich stark sind. Klafft zwischen ihnen eine große Fähigkeitslücke, kostet dieselbe Ersparnis gut zehn Prozent Qualität. Ein Jahr später legte ein Team aus Berkeley mit RouteLLM nach und berichtete ähnliche Größenordnungen. Auch hier steht die Einschränkung im Papier selbst. Auf Aufgabentypen, die der Router im Training nicht gesehen hatte, fielen seine Entscheidungen auf Zufallsniveau.
Das schärfste Urteil kam Ende 2025 von außen. Eine Gruppe an der Rice University baute mit RouterArena die erste unabhängige Vergleichsplattform und ließ zwölf Router gegeneinander antreten, akademische wie kommerzielle. Kein einziger erreichte das theoretisch mögliche Optimum. Ein Großteil landete nah bei den Kosten des jeweils stärksten Modells, verschenkte also genau die Ersparnis, für die er gebaut worden war. Ein Router kostete am Ende fast das Vierfache der Vergleichskosten und lieferte dabei keine bessere Trefferquote. Nur zwei der zwölf erreichten eine echte Ersparnis von rund 35 Prozent bei weniger als zwei Prozent Genauigkeitsverlust. Schon Tippfehler oder umformulierte Fragen änderten die Weiterleitung.
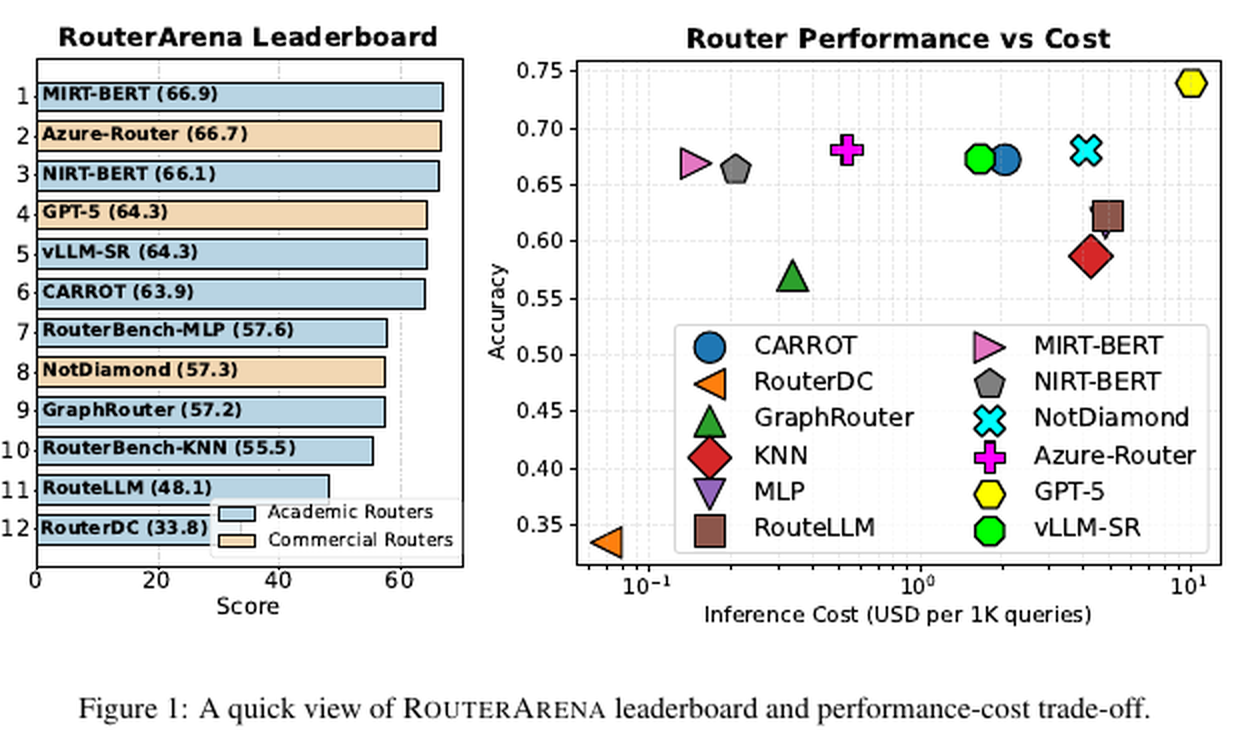
Grafik: Lu et al., RouterArena, arXiv:2510.00202, Figure 1 (Bildzitat). Das rechte Diagramm zeigt das Kernproblem. Die meisten Router landen in einem schmalen Genauigkeitsband, während ihre Kosten um mehr als das Hundertfache auseinanderliegen. Wer den falschen wählt, zahlt ein Vielfaches für dieselbe Trefferquote.
An dieser Stelle stand die Forschung 2026 also da. Die Idee funktioniert, aber ihr Nutzen hängt an Bedingungen. Gemessen wurde fast ausschließlich im Labor. Der einzige begutachtete Übersichtsartikel zum Thema, im Frühjahr 2026 im Journal of Artificial Intelligence Research erschienen, benennt genau das als offenes Problem: Die Experimente sind untereinander kaum vergleichbar. Kosten jenseits der reinen Rechnung, etwa Wartezeit oder Energie, tauchen fast nie auf.
Vom Papier ins Produkt
Marktreif ist die Idee längst. Den ersten kommerziellen Router brachte das Startup Martian im November 2023, Not Diamond folgte 2024. Amazon lieferte Intelligent Prompt Routing für Bedrock im April 2025 allgemein verfügbar aus und nannte dabei bis zu 30 Prozent Ersparnis, Microsoft zog im November 2025 mit dem Model Router in Foundry nach, inklusive der drei Modi Quality, Cost und Balanced. Unter den Programmierwerkzeugen war GitHub Copilot im September 2025 zuerst dran, Windsurf folgte im April 2026 und Factory im Juni. Cursors Router erschien am 22. Juli 2026 und ist damit der vierte in dieser Reihe.
Zwei Dinge fallen an diesem Bild auf. Anthropic bietet bis heute keinen an, dort steuert man den Aufwand innerhalb eines Modells oder wechselt nach festen Regeln.
Und OpenAI hat die eigene Automatik wieder eingeschränkt. Mit GPT-5 kam im August 2025 ein Modell, das in ChatGPT selbstständig zwischen schnellen und nachdenkenden Varianten umschaltet. Im Dezember 2025 nahm OpenAI das für Gratis- und Go-Nutzer zurück, begründet mit Nutzerrückmeldungen. In der Programmierschnittstelle gab es die Automatik ohnehin nie. Routing ist also kein Selbstläufer, sondern eine Wette, die auch zurückgenommen wird.
Was in dieser Reihe fehlte, waren belastbare Zahlen darüber, ob sich der Aufwand im Alltag rechnet. Genau dort setzt Cursor an, mit einer Entwicklungsumgebung, durch die nach eigenen Angaben wöchentlich hunderte Millionen Anfragen laufen.
Der Praxistest
Das Ausgangsproblem beschreibt Cursor selbst sehr anschaulich. Rund 60 Prozent der Entwickler stellen einmal ein Modell ein und lassen es danach alles erledigen. Damit wird Routinearbeit dauerhaft zu Spitzenpreisen abgerechnet. Der neue Router sortiert stattdessen jede Anfrage vorher ein und schickt Einfaches an günstige Modelle, während schwierige Probleme bei den starken bleiben.
Zwei Entscheidungen machen diesen Test aufschlussreicher als die bisherigen Laborstudien. Erstens misst Cursor im laufenden Betrieb statt in Testreihen. Die Begründung ist praktisch: Wer mitten in einem Gespräch das Modell wechselt, verliert den zwischengespeicherten Kontext und zahlt dafür. In Labortests taucht dieser Posten nicht auf, in der Rechnung schon. Zweitens wechselt Cursor die Messgröße. Statt zu fragen, was eine Anfrage kostet, fragt das Unternehmen, was ein fertiger Commit kostet, also ein tatsächlich abgeschlossenes Stück Arbeit.
Die Ergebnisse fallen deutlich aus. Bei drei Firmenkunden im Early Access sanken die Kosten laut Cursor um 30 bis 50 Prozent gegenüber dem durchgehenden Einsatz von Opus 4.8, im Online-A/B-Test erreichte der Intelligence-Modus bis zu 60 Prozent Ersparnis, ohne dass die Zufriedenheit der Nutzer gelitten hätte.
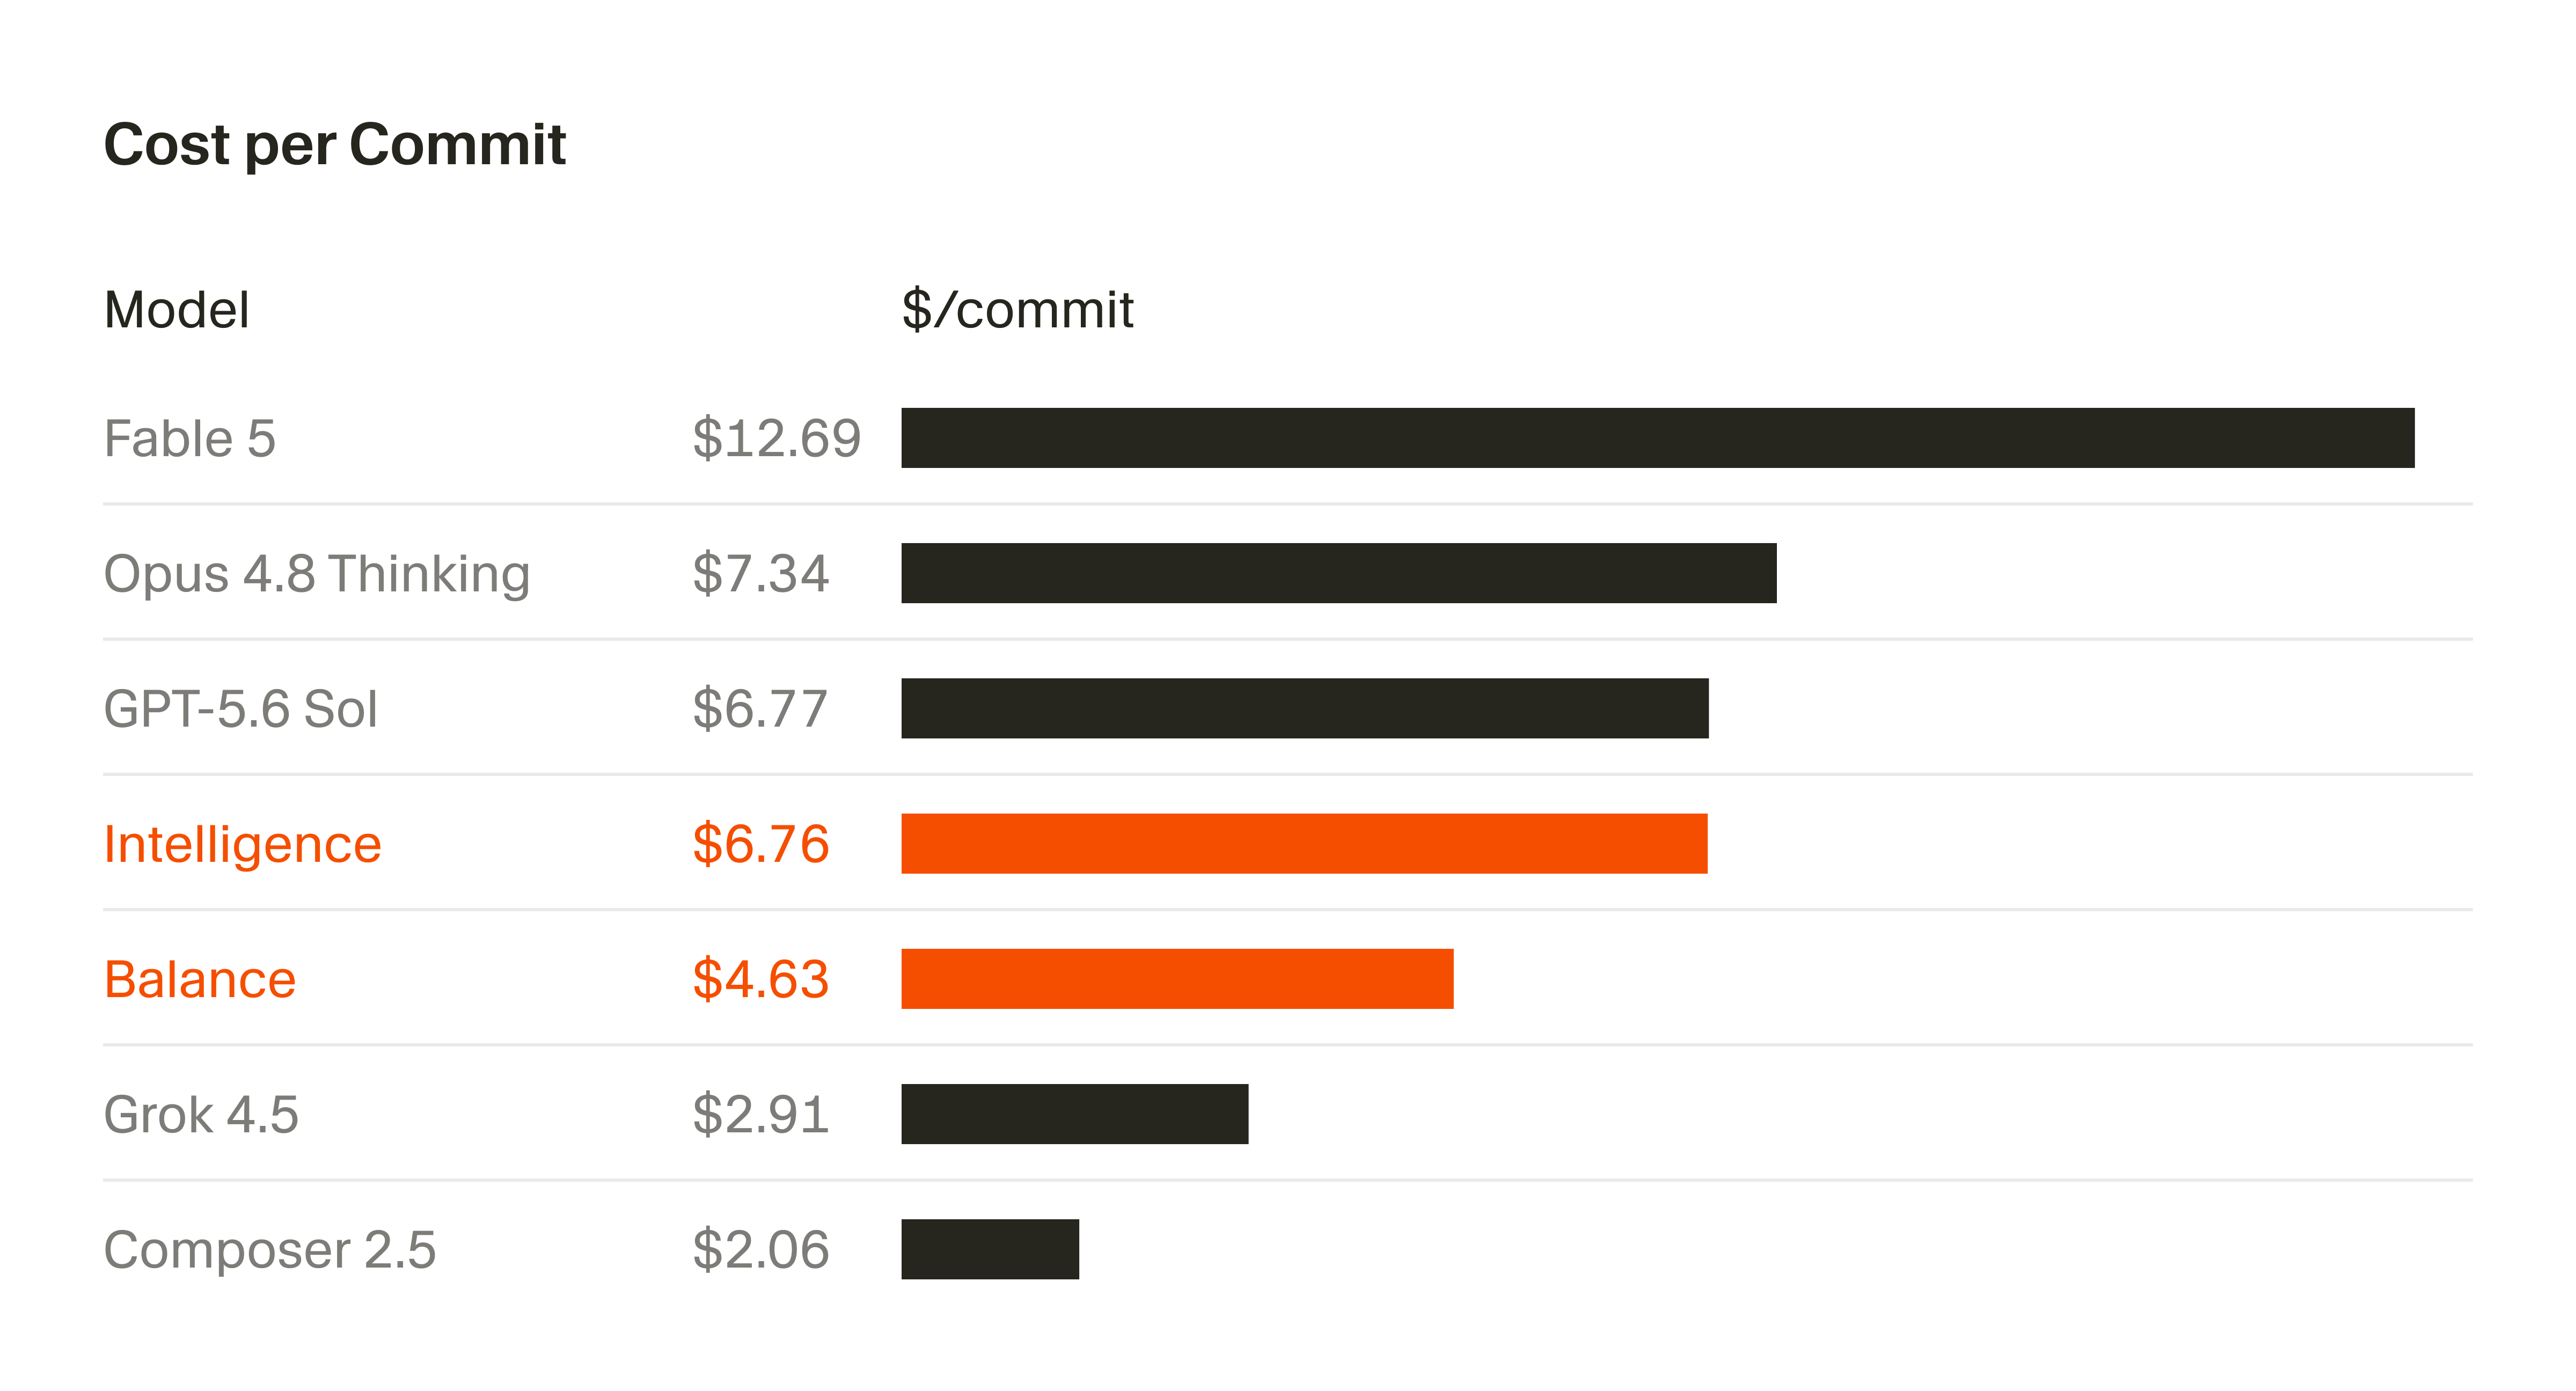
Grafik: Cursor, „Introducing Cursor Router” (Bildzitat, Anbieterangabe). Die beiden orange markierten Balken sind die Router-Modi.
Die Grafik zeigt allerdings mehr, als die Ankündigung betont. Gegen die teuersten Modelle spart der Router deutlich, gegen Fable 5 etwa zwei Drittel. Zwei einzelne Modelle liegen aber noch darunter: Grok 4.5 kommt auf 2,91 Dollar pro Commit, Cursors eigenes Composer 2.5 auf 2,06 Dollar. Wer nur auf die Rechnung schaut, fährt mit einem festen günstigen Modell also billiger als mit dem Router. Dessen Versprechen ist ein anderes, nämlich Spitzenqualität dort zu liefern, wo sie gebraucht wird, ohne sie überall zu bezahlen. Das ist ein Kompromiss, keine Kostenminimierung.
Diese Zahlen stammen vom Anbieter und beschreiben sein eigenes Produkt. Nachgeprüft hat sie bislang niemand. Sie sind deshalb keine unabhängige Bestätigung der Forschung, sondern ein Praxisbericht mit wirtschaftlichem Eigeninteresse. Bemerkenswert bleiben sie trotzdem, weil sie aus einer Datenmenge stammen, die keine Universität aufbringen kann.
Die zweite Zahl
Vier Tage vor der Produktankündigung veröffentlichte Cursor einen Forschungsbericht, der viel weniger Aufmerksamkeit bekam. Darin ließ das Unternehmen mehrere KI-Agenten gemeinsam die Datenbank SQLite in der Programmiersprache Rust nachbauen. Als Vorlage diente allein das 835 Seiten lange Handbuch. Quellcode, Testsuite und Internetzugang blieben gesperrt.
Unter kontrollierten Bedingungen liefen vier Kombinationen aus Modellen, dazu zwei weitere Durchläufe allein zur Kostenkalibrierung. Bewertet wurde mit sqllogictest, einer Testsuite des SQLite-Projekts, die Millionen Abfragen mit bekannten Ergebnissen enthält. Die Agenten erfuhren nie, dass es diese Suite gibt. Nach jedem Durchlauf prüfte Cursor zusätzlich von Hand, ob das System gleichmäßig gebaut wurde oder nur dort, wo die Tests hinsehen. Alle vier kontrollierten Kombinationen bestanden am Ende die vollständige Suite. Ihre Kosten lagen zwischen 1.339 und 10.565 Dollar. Das ist ein Faktor von fast acht für ein geprüft gleichwertiges Ergebnis.
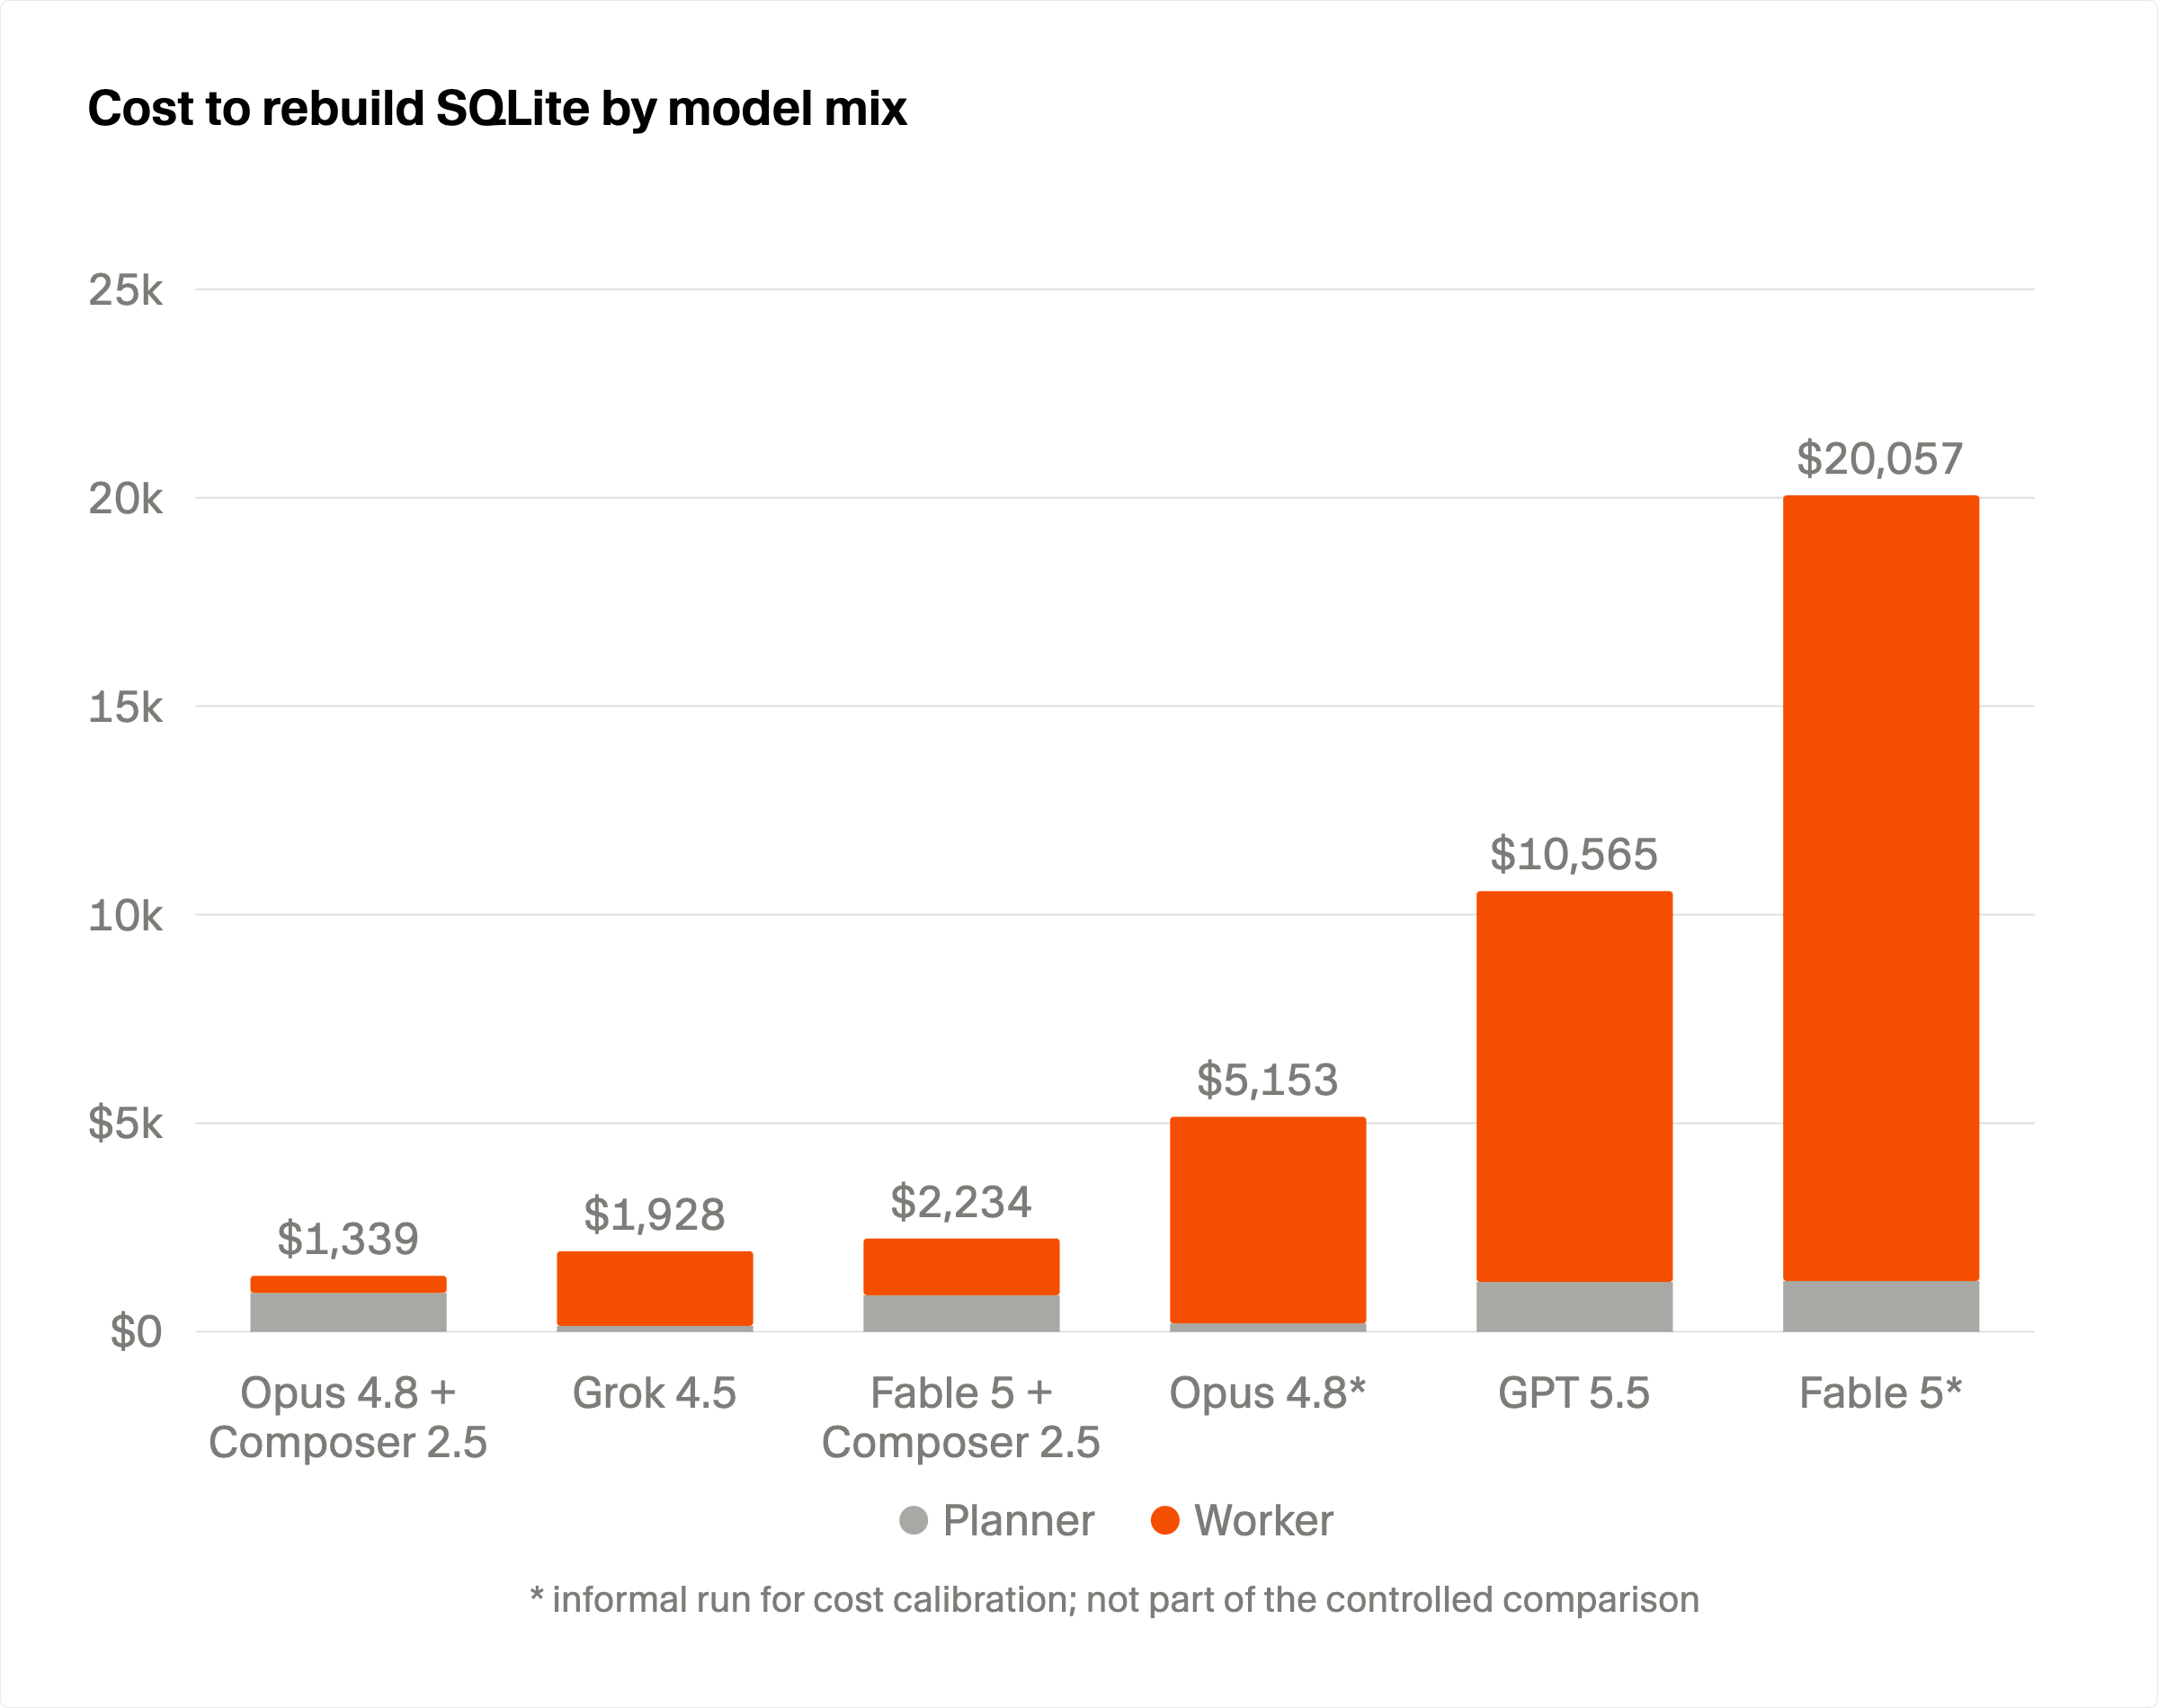
Grafik: Cursor, „Agent swarms and the new model economics” (Bildzitat, Anbieterangabe).
Zwei Balken dieser Grafik gehören nicht zum eigentlichen Vergleich. Die beiden mit Sternchen markierten Läufe, darunter der teuerste mit 20.057 Dollar, hat Cursor nur gefahren, um ein Gefühl für die Kosten eines einzeln arbeitenden Spitzenmodells zu bekommen. Bewertet wurden sie nach eigener Angabe nur beiläufig, weshalb das Unternehmen daraus ausdrücklich keine Qualitätsschlüsse zieht. Der kontrollierte Vergleich umfasst die übrigen vier Läufe. Für die nennt Cursor selbst die Spanne von 1.339 bis 10.565 Dollar.
Auch innerhalb dieser vier verlangt die Grafik eine Differenzierung, die in der Schlagzeile leicht untergeht. Der Achtfach-Unterschied vergleicht GPT-5.5 mit dem günstigsten Hybrid. Dabei ändern sich zwei Dinge gleichzeitig: die Rollenverteilung und das eingesetzte Modell. Grok 4.5 erledigte die Aufgabe ganz ohne Rollentrennung für 1.928 Dollar und liegt damit näher am günstigsten Hybrid als an GPT-5.5. Ein effizientes Modell allein bringt also bereits einen erheblichen Teil des Effekts.
Sauber isolieren lässt sich die Rollenverteilung an einer anderen Stelle. In jedem Balken ist der graue Planungsanteil klein und der orangefarbene Ausführungsanteil groß. Ließ man ein einziges starkes Modell alles machen, kosteten allein die ausführenden Schritte 9.373 Dollar. In der Variante mit geteilten Rollen kostete die gesamte Ausführung 411 Dollar. Das ist derselbe Arbeitsschritt, einmal von einem Spitzenmodell erledigt und einmal von einem günstigen unter Anleitung. Die Ausführer erzeugten dabei über 90 Prozent aller Token und verursachten trotzdem nur einen kleinen Teil der Kosten.
Warum das funktioniert, zeigt Cursor in einer eigenen Skizze.
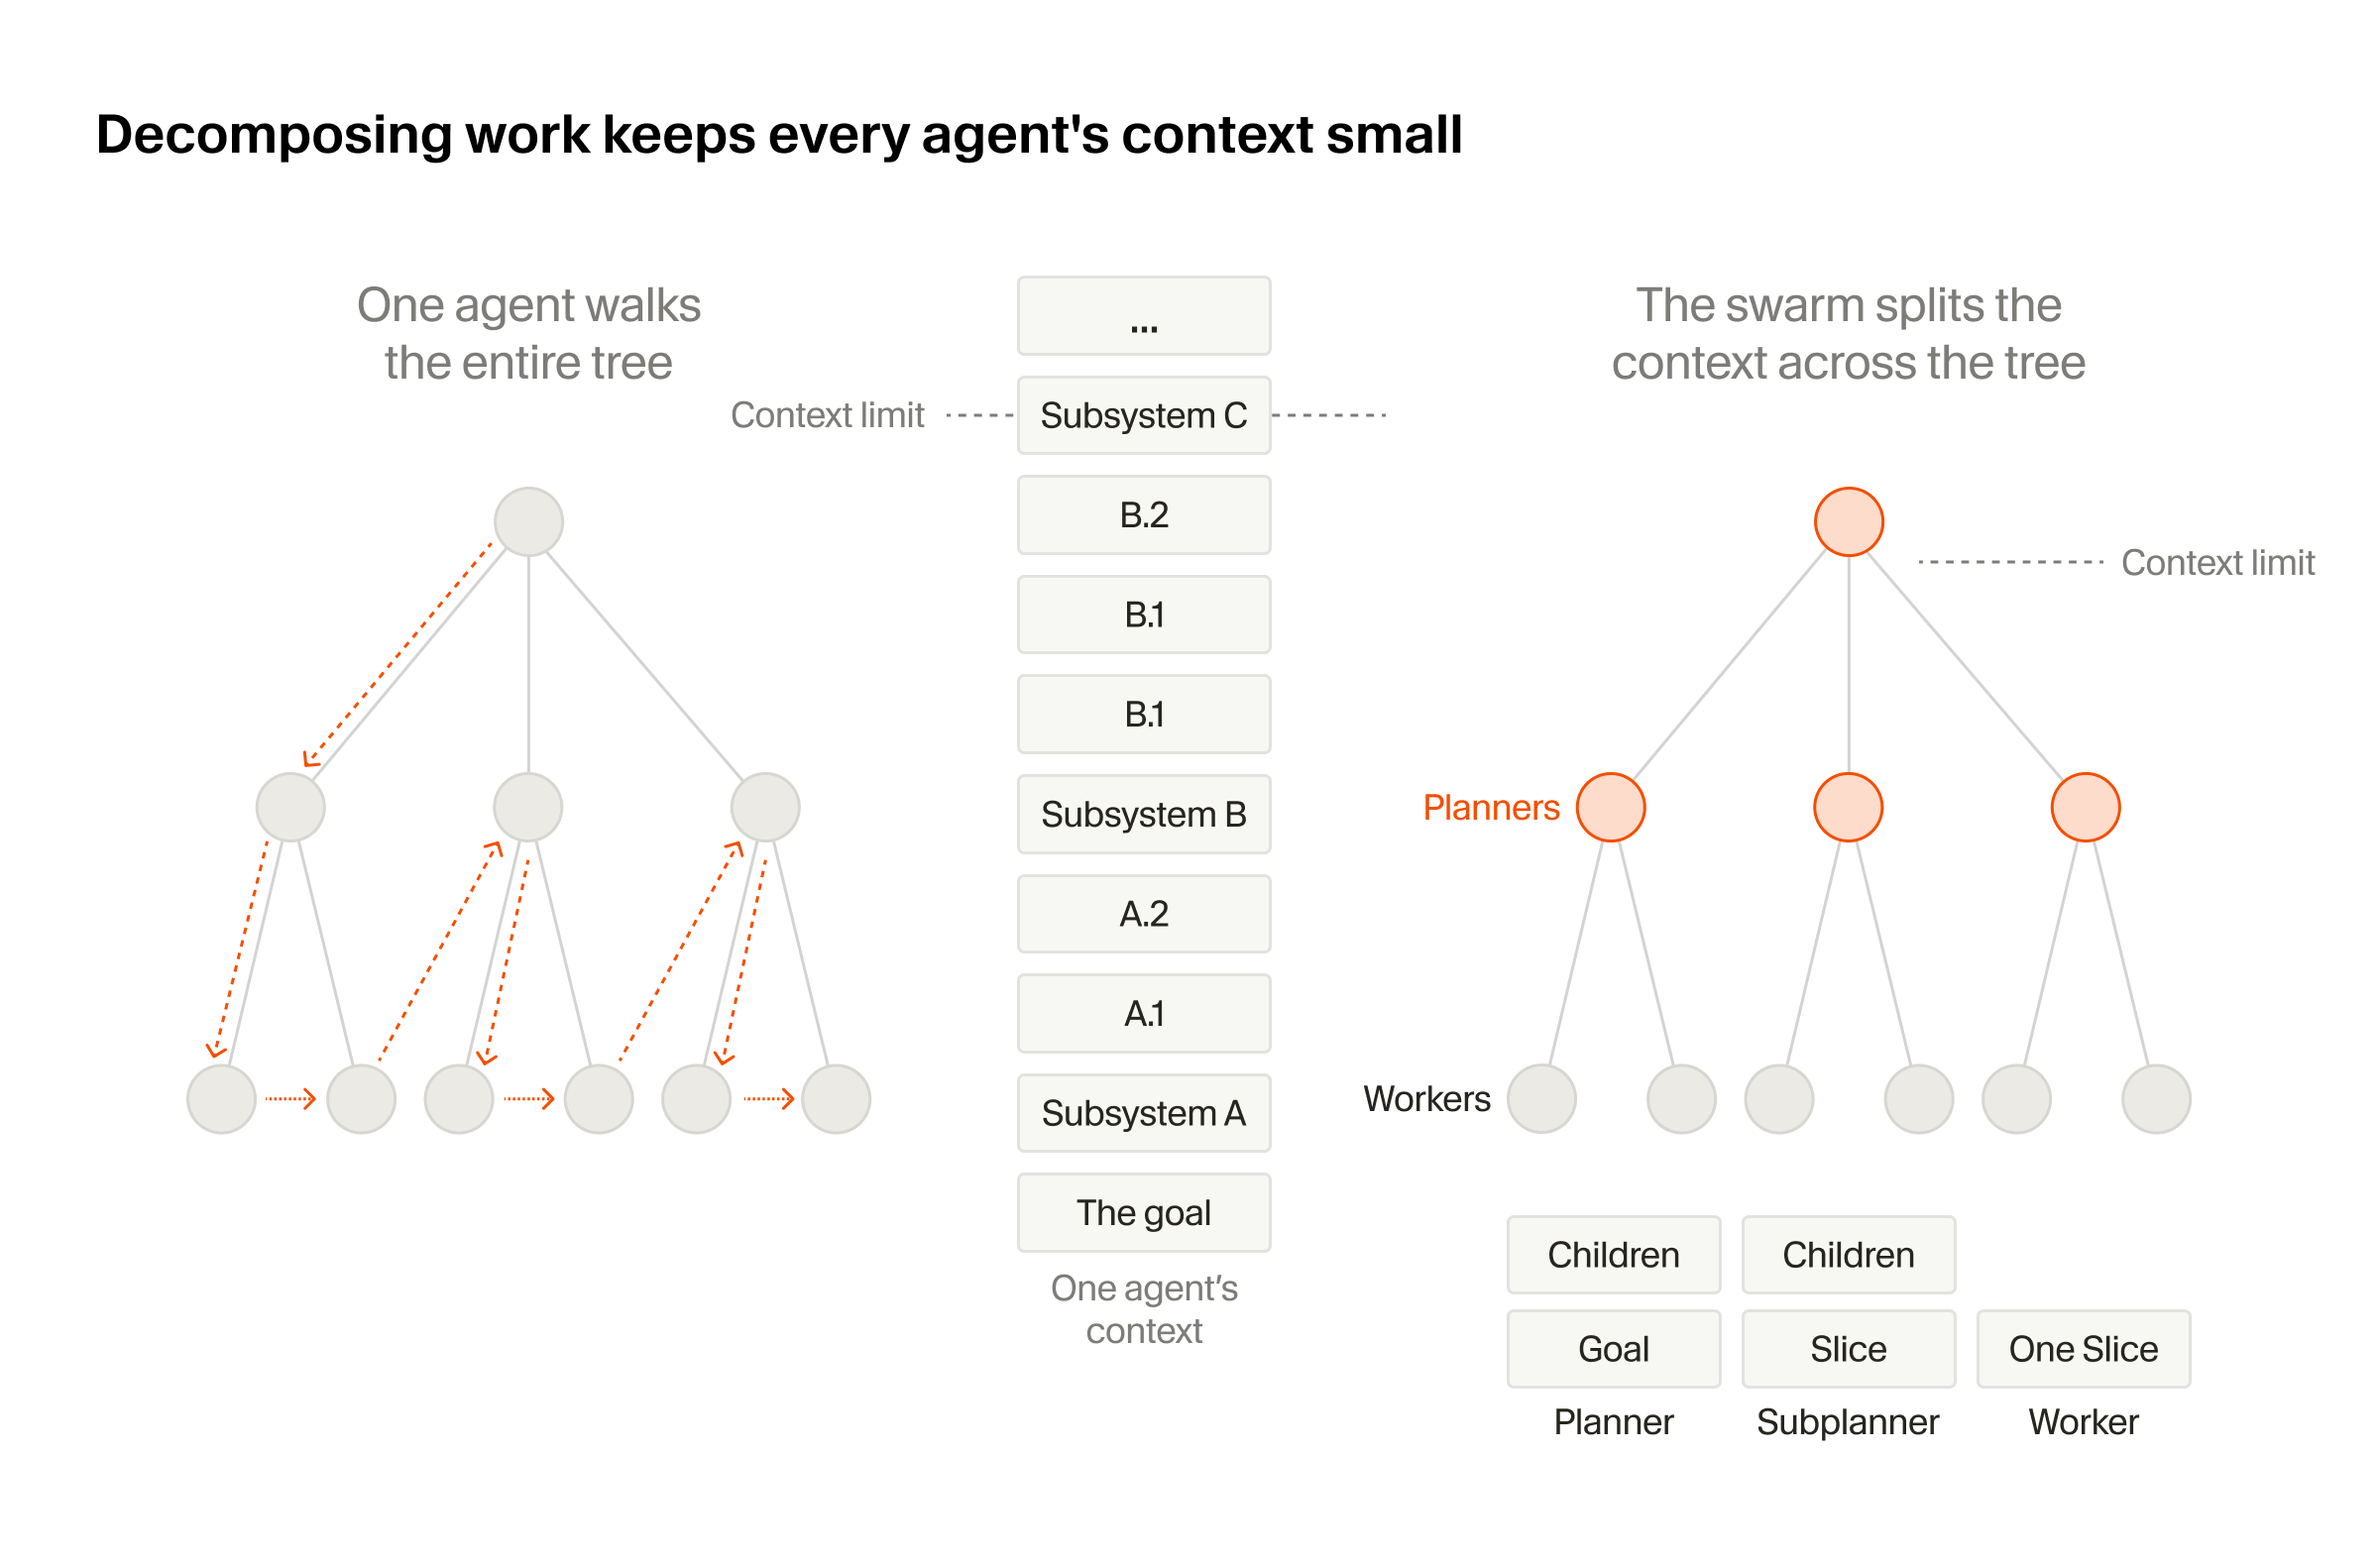
Grafik: Cursor, „Agent swarms and the new model economics” (Bildzitat, Anbieterangabe).
Ein einzelner Agent muss den ganzen Aufgabenbaum im Kopf behalten, also das Ziel, seine aktuelle Position und alle Zwischenebenen. Im Schwarm plant der eine nie selbst mit und der andere implementiert nie, weshalb beide mit einem viel kleineren Ausschnitt auskommen.
Cursors eigene Erklärung dafür ist die überzeugendste Passage des Berichts. Nur wenige Momente einer großen Aufgabe brauchen wirklich Spitzenintelligenz, nämlich die anfängliche Zerlegung und einzelne Grundsatzentscheidungen. Sobald jemand die Mehrdeutigkeit einmal in eine klare Anweisung aufgelöst hat, muss der Rest ihr nur noch folgen.
Das Unternehmen verweist an dieser Stelle selbst auf Ronald Coase. Der Ökonom fragte 1937, warum es Unternehmen überhaupt gibt. Seine Antwort war, dass Koordination teurer wird als die Arbeit selbst, sobald jeder mit jedem sprechen muss. Wie richtig das ist, zeigt der Vergleich mit dem älteren Aufbau. Der produzierte in zwei Stunden 68.000 Commits und über 70.000 Konflikte zwischen den Agenten, die sich gegenseitig überschrieben. Der neue Aufbau kam in vier Stunden auf weniger als tausend.
Hier gilt derselbe Vorbehalt wie beim Router. Das Experiment stammt vom Anbieter, es gab einen Durchlauf je Konfiguration und niemand hat es außerhalb von Cursor wiederholt.
Wichtig ist außerdem, worin sich die beiden Hebel unterscheiden. Beim Routing bekommt dieselbe Aufgabe ein anderes Modell. Bei der Rollenverteilung verändert sich die Aufgabe selbst, weil das teure Modell die Mehrdeutigkeit vorher auflöst. Erst dadurch wird die Arbeit so eindeutig, dass ein günstiges Modell sie überhaupt erledigen kann. Das eine ist eine Frage der Beschaffung, das andere eine Frage des Zuschnitts.
Sparen heißt nicht weniger ausgeben
Ein Effekt kommt hinzu, den Cursor selbst dokumentiert. Nach größeren Modellverbesserungen Ende 2025 schickten die Nutzer 44 Prozent mehr Anfragen pro Woche, bei besonders komplexer Arbeit sogar 68 Prozent mehr. Wenn KI besser und billiger wird, trauen sich Teams an Aufgaben heran, die vorher zu teuer oder zu unsicher waren.
Das ist zunächst genau das, was man will. Der Anwendungsbereich weitet sich aus. Es wird Arbeit erledigt, die vorher liegen geblieben ist. Cursor rahmt den Befund selbst so und spricht von einer Dynamik im Sinne von Jevons. Der Ökonom William Stanley Jevons beobachtete 1865, dass effizientere Dampfmaschinen den Kohleverbrauch Englands nicht senkten, sondern steigerten, weil sich der Einsatz von Kohle plötzlich an mehr Stellen lohnte. Volkswirtschaftlich war das Wachstum, nicht Verschwendung.
Für die Planung folgt daraus trotzdem etwas Unbequemes. Sinkende Kosten je Aufgabe senken nicht die Gesamtrechnung, sie verschieben nur, wofür sie anfällt. Ob sich das lohnt, entscheidet sich daran, ob der Wert der zusätzlichen Arbeit schneller wächst als ihre Kosten.
Wichtig ist dabei die Einordnung. Für Energie ist dieser Rebound-Effekt gut untersucht. Übersichtsarbeiten schätzen, dass er mehr als die Hälfte der erwarteten Einsparungen aufzehrt. Für KI-Rechenleistung ist er bislang eine gut begründete Vermutung. Die einzige begutachtete Arbeit, die Jevons ausdrücklich auf KI anwendet, ist ein Diskussionsbeitrag ohne eigene Messung. Cursors 44 Prozent sind ein Indiz, kein Nachweis.
Was Unternehmen daraus mitnehmen können
Der erste Punkt ist die Messgröße. Wer KI-Kosten in Preisen pro Token verhandelt, optimiert die falsche Größe. Ein Forscherteam um Mehmet Hamza Erol hat dafür 2026 einen sauberen Begriff vorgeschlagen, die Kosten pro bestandener Aufgabe, also Kosten geteilt durch Erfolgswahrscheinlichkeit. Dieselbe Arbeit enthält einen ernüchternden Nebenbefund. Die verbreiteten Tricks, ein Modell mehrfach nachdenken oder sich selbst korrigieren zu lassen, brachten bei zwei von drei untersuchten Aufgabenklassen keine messbare Kostenverbesserung. Der Fortschritt kam dort aus besseren Modellen, nicht aus zusätzlichen Schleifen.
Der zweite Punkt ist der wichtigere. Ein Modell zu wechseln ist schnell entschieden. Die Arbeit so zuzuschneiden, dass ein günstiges Modell sie erledigen kann, verlangt dagegen, dass jemand sie überhaupt erst sauber zerlegt.
Und der dritte Punkt betrifft die Zahlen, mit denen der Nutzen üblicherweise begründet wird. Cursor führt zwei davon in einem Beitrag zum eigenen CFO Council an, einem Gremium aus Finanzverantwortlichen, das das Unternehmen selbst gegründet hat. McKinsey berichtet, dass 88 Prozent der befragten Organisationen KI regelmäßig in mindestens einem Bereich einsetzen, während nur 39 Prozent überhaupt eine Wirkung auf das Betriebsergebnis zuschreiben. Der Bericht ergänzt allerdings, dass die meisten dieser 39 Prozent eine Wirkung von unter fünf Prozent nennen und nur etwa sechs Prozent aller Befragten als wirklich erfolgreich gelten. Die zweite Zahl stammt von BCG, das Firmen mit dem höchsten Token-Verbrauch ein Umsatzwachstum von 16,5 Prozent zuschreibt gegenüber 5,1 Prozent bei den sparsamsten.
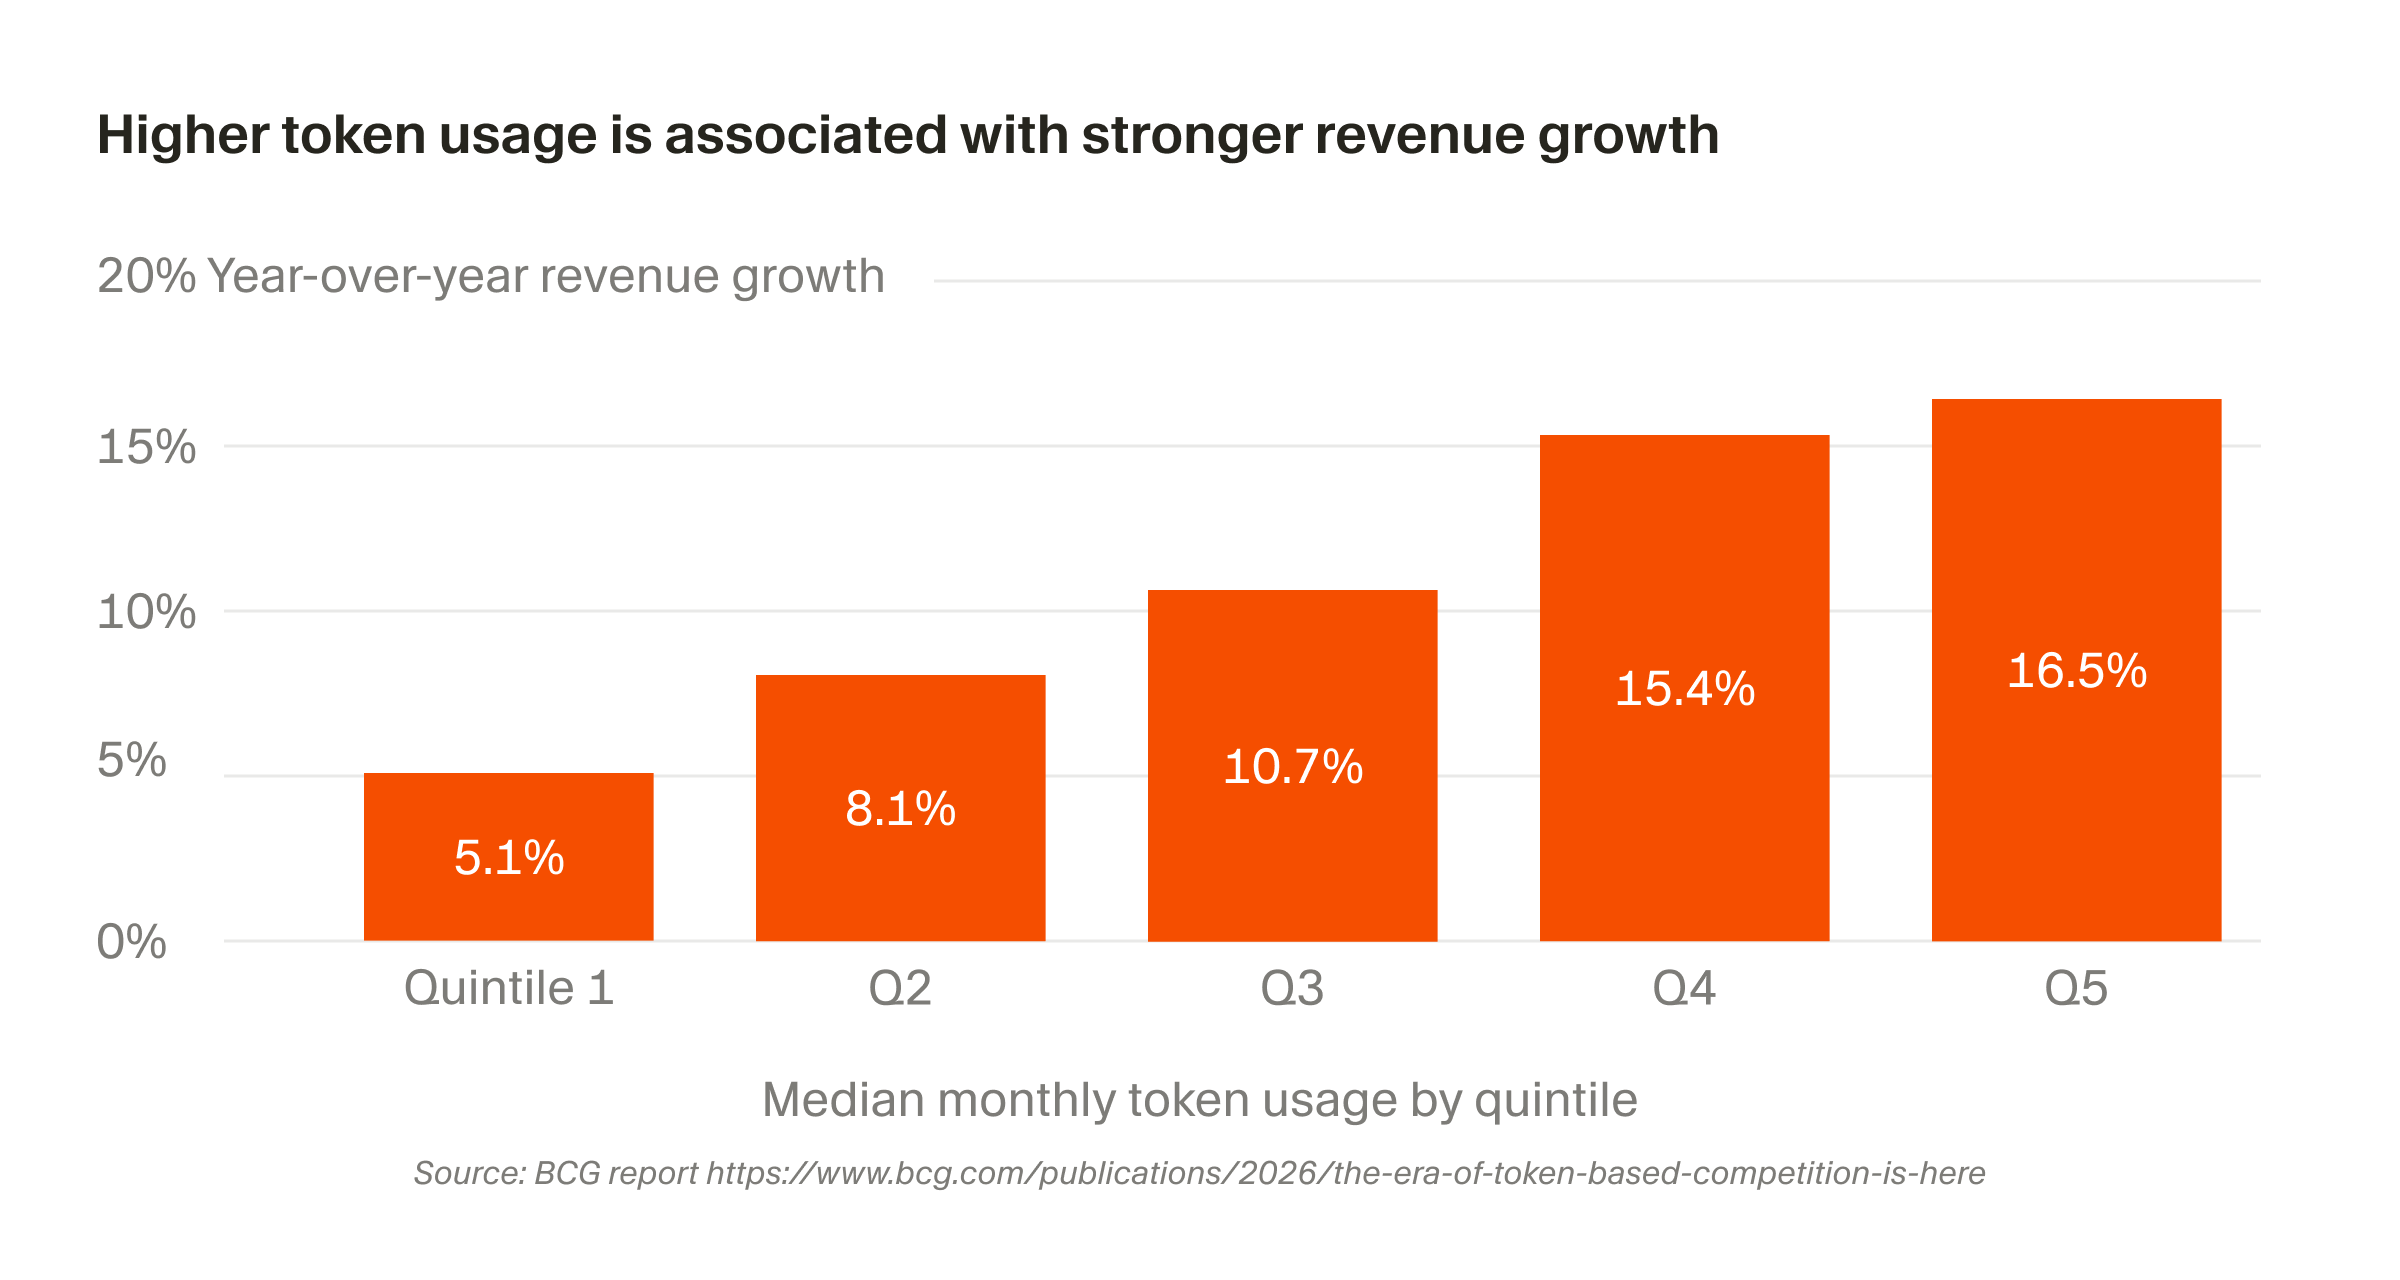
Grafik: Boston Consulting Group, „The Era of Token-Based Competition Is Here”, Juni 2026 (Bildzitat). Datenquelle laut Quellenangabe der Grafik: Cursor.
Die vollständige Reihe ist aufschlussreicher als das zitierte Extrempaar. Zwischen dem ersten und dem vierten Quintil steigt das Wachstum um gut zehn Prozentpunkte, zwischen dem vierten und dem fünften nur noch um gut einen. Der Effekt flacht oben also deutlich ab. BCG selbst formuliert den Befund ausdrücklich als Zusammenhang und nicht als Ursache, kontrolliert nicht für Unternehmensgröße oder Wachstumsphase und stützt sich dabei auf Daten von Cursor. Dass wachsende Firmen einfach mehr Werkzeuge einkaufen, wird in der Analyse nicht diskutiert.
Die Zuweisung selbst muss dabei niemand mehr von Hand vornehmen. Innerhalb der Entwicklungsumgebung übernimmt das der Router, im Schwarm entscheidet ein planender Agent über die Zerlegung. Beides ist Produkt geworden, nicht Organisation. Es reicht genau so weit wie das Werkzeug. Für Buchhaltung, Kundenservice oder juristische Prüfungen gibt es diese Automatik nicht.
Damit bleibt die Frage, die dieser Beitrag nicht beantworten kann. Sämtliche Erfolgszahlen zu diesem Produkt stammen von dem Unternehmen, das es verkauft. Sie sind plausibel und beruhen auf einer Datenmenge, die keine Universität aufbringt. Trotzdem bleiben es Verkaufsargumente. Die einzige unabhängige Vergleichsevaluation fiel deutlich nüchterner aus. Dort erreichte kein einziger getesteter Router das Optimum, ein Großteil landete nah bei den Kosten des stärksten Modells. Schon Tippfehler änderten die Entscheidungen. Ob Cursors Router in fremden Codebasen und mit fremden Arbeitsweisen ähnlich gut abschneidet wie in den eigenen Messungen, hat bisher niemand geprüft.
Für Unternehmen folgt daraus etwas sehr Praktisches. Wer Routing einführt, kauft keine belegte Ersparnis, sondern eine begründete Vermutung. Belegen lässt sie sich nur im eigenen Betrieb. Dafür braucht es genau die Messgröße vom Anfang dieses Abschnitts: nicht den Preis pro Token, sondern die Kosten pro erledigter Aufgabe.
Quellen
- Chen, L., Zaharia, M., & Zou, J. (2023). FrugalGPT: How to Use Large Language Models While Reducing Cost and Improving Performance. arXiv:2305.05176 (Preprint, nicht begutachtet).
- Ding, D., Mallick, A., Wang, C., Sim, R., Mukherjee, S., Ruhle, V., Lakshmanan, L. V. S., & Awadallah, A. H. (2024). Hybrid LLM: Cost-Efficient and Quality-Aware Query Routing. ICLR 2024. arXiv:2404.14618.
- Ong, I., Almahairi, A., Wu, V., Chiang, W.-L., Wu, T., Gonzalez, J. E., Kadous, M. W., & Stoica, I. (2025). RouteLLM: Learning to Route LLMs with Preference Data. ICLR 2025. arXiv:2406.18665.
- Lu, Y., Liu, R., Yuan, J., Cui, X., Zhang, S., Liu, H., & Xing, J. (2025). RouterArena: An Open Platform for Comprehensive Comparison of LLM Routers. arXiv:2510.00202 (Preprint, nicht begutachtet).
- Varangot-Reille, C., Bouvard, C., Ciancone, M., Gourru, A., Schaeffer, M., & Jacquenet, F. (2026). Doing More with Less: A Survey on Routing Strategies for Resource Optimisation in Large Language Model-Based Systems. Journal of Artificial Intelligence Research, 86. DOI: 10.1613/jair.1.19801.
- Erol, M. H., El, B., Suzgun, M., Yüksekgönül, M., & Zou, J. (2026). Cost-of-Pass: An Economic Framework for Evaluating Language Models. ICLR 2026. arXiv:2504.13359.
- Luccioni, A. S., Strubell, E., & Crawford, K. (2025). From Efficiency Gains to Rebound Effects: The Problem of Jevons’ Paradox in AI’s Polarized Environmental Debate. FAccT 2025, S. 76–88. DOI: 10.1145/3715275.3732007.
- Brockway, P. E., Sorrell, S., Semieniuk, G., Heun, M. K., & Court, V. (2021). Energy efficiency and economy-wide rebound effects: A review of the evidence and its implications. Renewable and Sustainable Energy Reviews, 141, 110781. DOI: 10.1016/j.rser.2021.110781.
- Coase, R. H. (1937). The Nature of the Firm. Economica, 4(16), S. 386–405. DOI: 10.1111/j.1468-0335.1937.tb00002.x.
- Amazon Web Services (2025). Amazon Bedrock Intelligent Prompt Routing is now generally available, 22. April 2025. https://aws.amazon.com/about-aws/whats-new/2025/04/amazon-bedrock-intelligent-prompt-routing-generally-available/
- Microsoft (2025/2026). What’s new for model router in Microsoft Foundry. Preview Mai 2025, allgemein verfügbar seit November 2025. https://learn.microsoft.com/en-us/azure/foundry/foundry-models/whats-new-model-router
- OpenAI (2025). GPT-5 System Card, 7. August 2025 (beschreibt den Real-Time-Router in ChatGPT). https://openai.com/index/gpt-5-system-card/
- OpenAI (2025). Introducing GPT-5 for developers, 7. August 2025 (belegt, dass der Router nicht Teil der API ist). https://openai.com/index/introducing-gpt-5-for-developers/
- GitHub (2025). Auto model selection for Copilot in VS Code in public preview, 15. September 2025. https://github.blog/changelog/2025-09-15-auto-model-selection-for-copilot-in-vs-code-in-public-preview/
- Cursor (2026). Agent swarms and the new model economics, 20. Juli 2026. https://cursor.com/blog/agent-swarm-model-economics (Anbieterquelle).
- Cursor (2026). Introducing Cursor Router. https://cursor.com/blog/router (Anbieterquelle, Produktankündigung).
- Cursor (2026). CFOs and the new economics of AI. https://cursor.com/blog/cfo-council (Anbieterquelle).
- McKinsey & Company (2025). The state of AI in 2025: Agents, innovation, and transformation, 5. November 2025. Online-Befragung von 1.993 Teilnehmern aus 105 Ländern, Feldzeit 25. Juni bis 29. Juli 2025, Selbstauskunft. https://www.mckinsey.com/capabilities/quantumblack/our-insights/the-state-of-ai
- Boston Consulting Group (2026). The Era of Token-Based Competition Is Here, 23. Juni 2026. Analyse von 107 börsennotierten Technologieunternehmen mit über 500 Mio. Dollar Umsatz, Zeitraum April 2025 bis März 2026, Datenquelle laut Quellenangabe der Grafik: Cursor. https://www.bcg.com/publications/2026/the-era-of-token-based-competition-is-here